MVSEP Logo
  • Главная
  • Новости
  • Тарифы
  • Демо
  • Инструменты
  • Создать учетную запись
  • Войти
  • Тема
    Выбор модели
    Язык
    • English
    • Русский
    • 中文
    • اَلْعَرَبِيَّةُ
    • Polski
    • Portugues do Brasil
    • Español
    • 日本語
    • Français
    • Oʻzbekcha
    • Türkçe
    • हिन्दी
    • Tiếng Việt
    • Deutsch
    • 한국어
    • Bahasa Indonesia
    • Italiano
    • Svenska
    • suomi
    • български език
    • magyar nyelv
    • עִבְֿרִית
    • ภาษาไทย
    • hrvatski
    • Română
    • Українська
    Server DE2

Алгоритмы

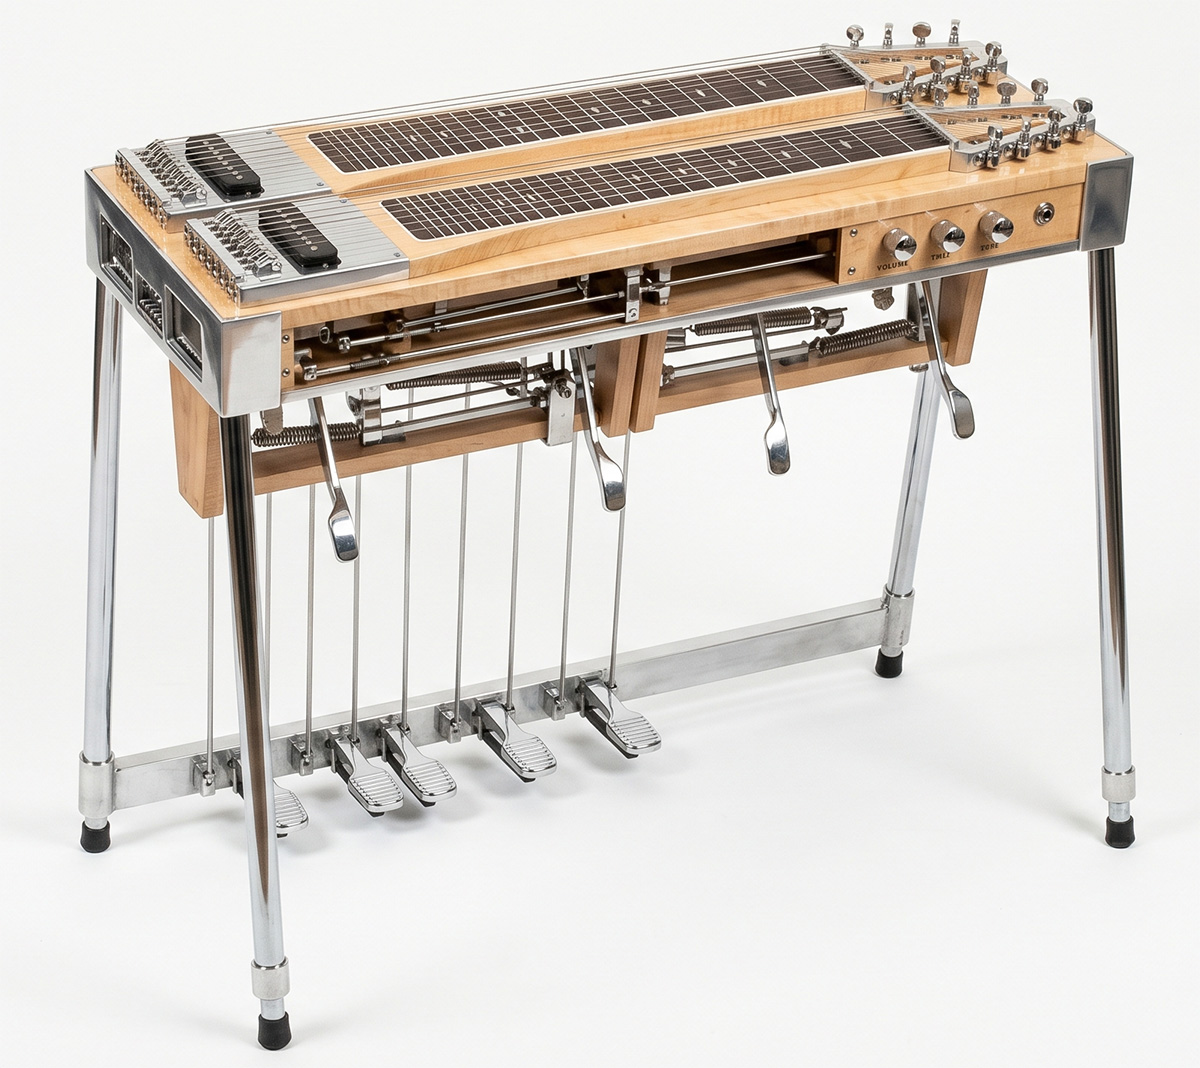
MVSep Pedal Steel Guitar

Педальная слайд-гитара - это разновидность электрогитары, которая устанавливается на специальной горизонтальной стойке (консоли). Музыкант играет на ней сидя, задействуя не только руки, но также ступни и колени.

Ключевые особенности инструмента:

  • Механика педалей и рычагов: Это главная отличительная черта инструмента. Система ножных педалей и коленных рычагов позволяет механически изменять натяжение (и высоту звука) определенных струн прямо во время игры. Это дает возможность играть сложные гармонические переходы и менять аккорды, не сдвигая руку на грифе.

  • Техника игры: На педал-стил-гитаре нет привычных ладов, которые нужно зажимать пальцами. Левой рукой гитарист плавно водит по струнам тяжелым металлическим цилиндром (слайдом или «стилом»), что создает характерный скользящий эффект (глиссандо). Правой рукой звук извлекается с помощью пластикового медиатора на большом пальце и металлических «когтей» на остальных пальцах.

  • Грифы и струны: Профессиональные модели часто имеют два параллельных грифа с разным строем (например, E9 для кантри и C6 для джаза и свинга). На каждом грифе обычно располагается по 10 или 12 струн.

Инструмент славится своим протяжным, певучим и часто «плачущим» тембром с очень долгим сустейном. Исторически и культурно педал-стил-гитара прочно ассоциируется с кантри-музыкой и вестерн-свингом. Однако благодаря своим уникальным выразительным возможностям, сегодня ее можно услышать в самых разных жанрах: от джаза и гавайской музыки до эмбиента, инди-рока и поп-музыки.

🗎 Копировать ссылку Use algorithm Demo

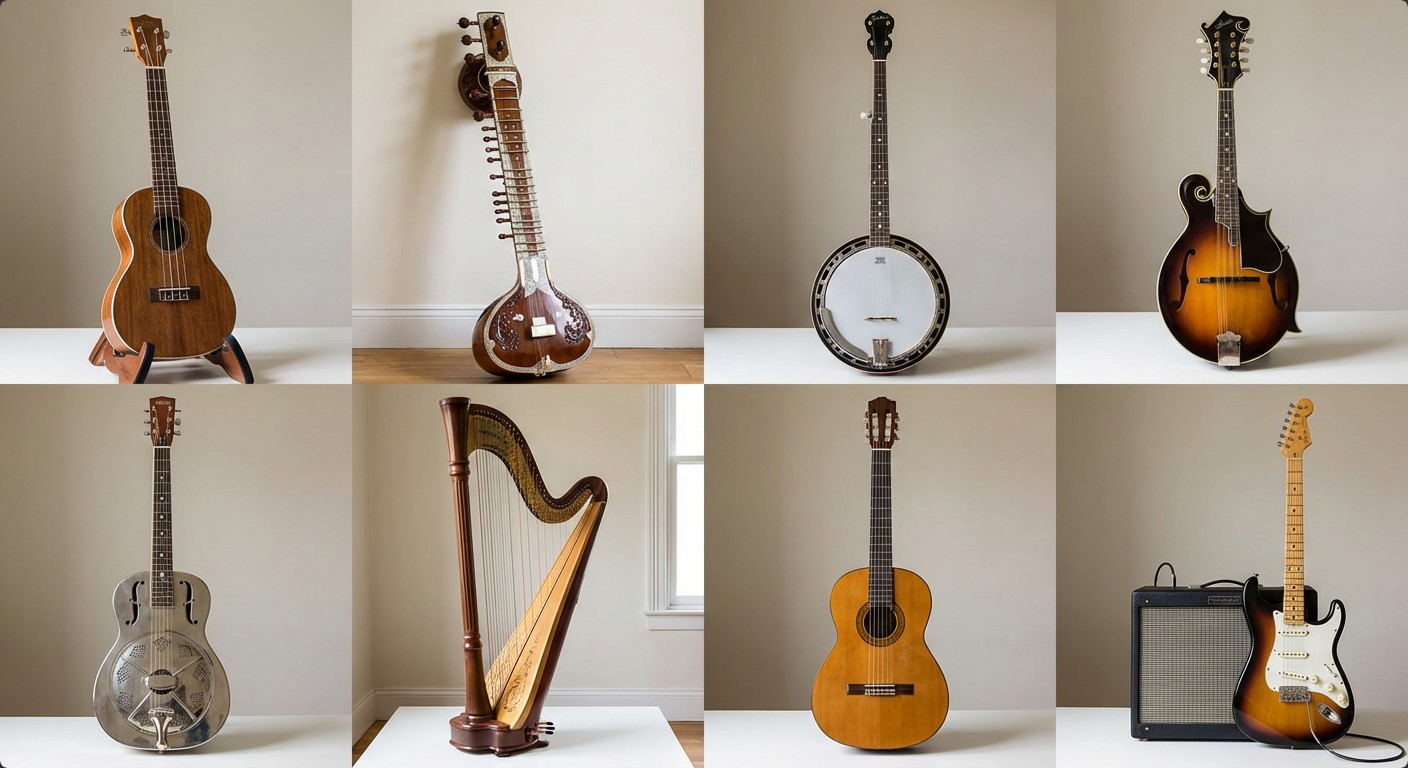
MVSep Plucked Strings (plucked-strings, other)

MVSep Plucked Strings — это высококачественная модель для разделения музыки на щипковые струнные инструменты и всё остальное. Список инструментов: укулеле, ситар, банджо, мандолина, добро, арфа, гитара, акустическая гитара, электрогитара.

🗎 Копировать ссылку Use algorithm Demo

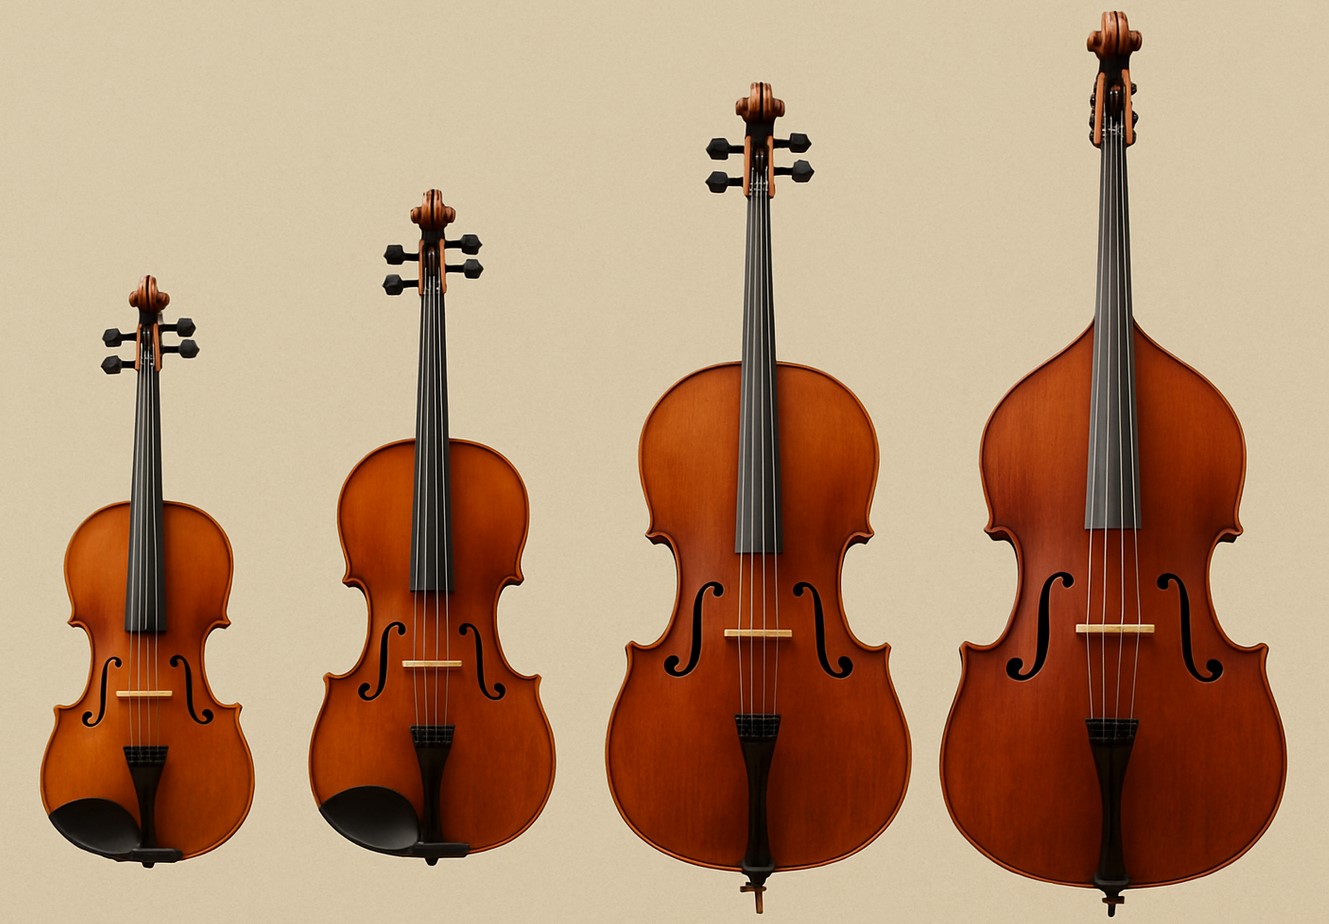
MVSep Bowed Strings (strings, other)

Модель MVSep Bowed Strings это высококачественная модель для разделения музыки на струнные смычковые инструменты и все остальное. Струнные включают в себя следующие инструменты: скрипка, альт, виолончель, контрабас.

🗎 Копировать ссылку Use algorithm Demo

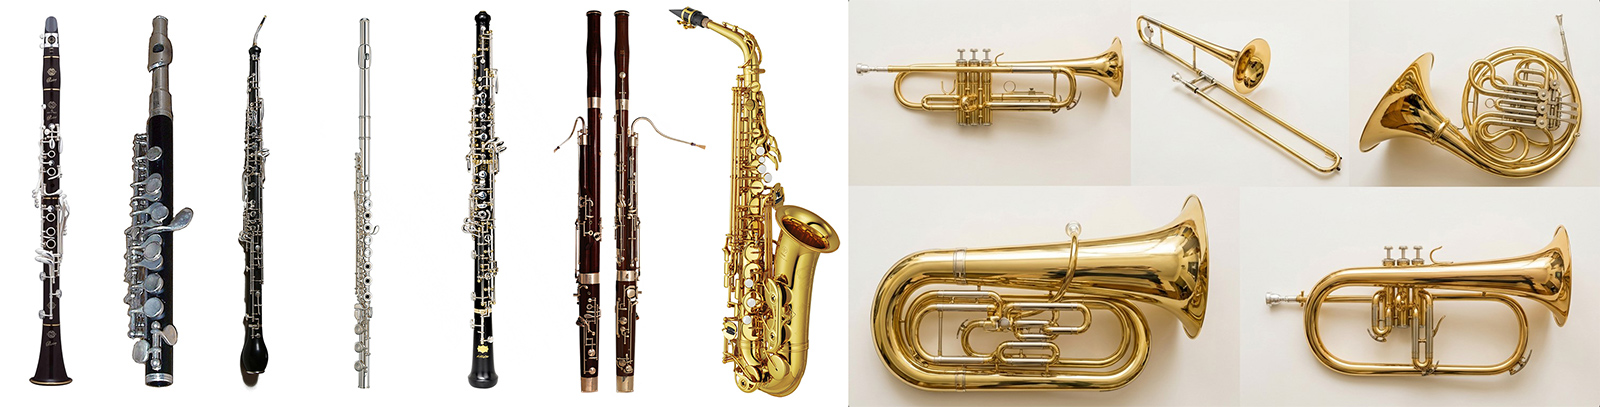
MVSep Wind (wind, other)

Модель MVSep Wind производит качественное разделение музыки на партию духовых инструментов и все остальное. Духовые включают в себя 2 категории инструментов: медные и деревянные духовые. Более конкретно мы включили в духовые: флейту, саксофон, трубу, тромбон, валторну, кларнет, гобой, губную гармошку, волынку, фагот, тубу, казу, пикколо, флюгельгорн, окарину, сякухати, мелодику, язычковые, диджериду, мюссетт, гайду.

Метрики качества

Algorithm name Wind dataset
SDR Wind SDR Other
MelBand Roformer 6.73 16.10
SCNet Large 6.76 16.13
MelBand + SCNet Ensemble 7.22 16.59
MelBand + SCNet Ensemble (+extract from Instrumental) --- ---
BS Roformer 9.82 19.19

🗎 Копировать ссылку Use algorithm Demo

MVSep Brass (brass, other)

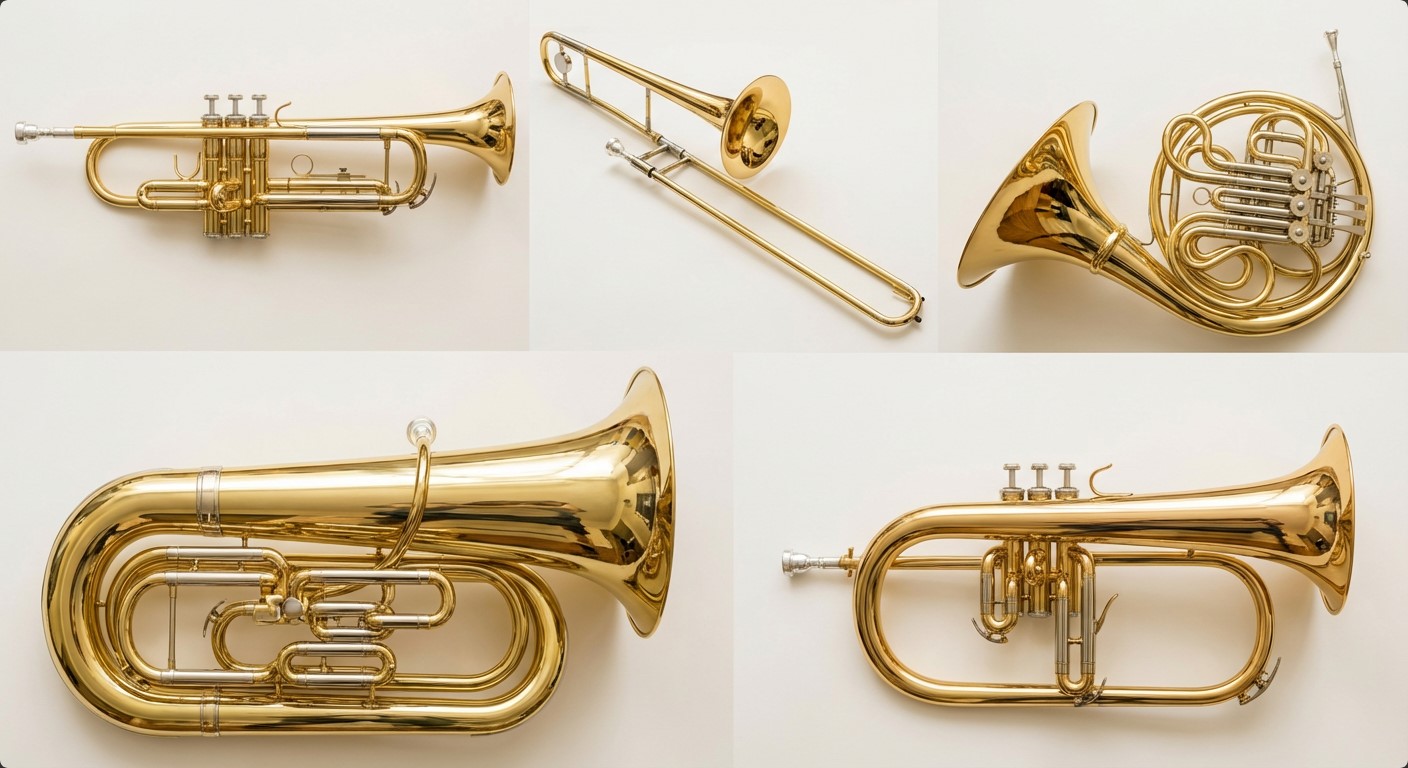
MVSep Brass — это высококачественная модель для разделения музыки на медные духовые инструменты и всё остальное. Список инструментов: труба, тромбон, валторна, туба, флюгельгорн, прочие медные духовые.

🗎 Копировать ссылку Use algorithm Demo

MVSep Woodwind (woodwind, other)

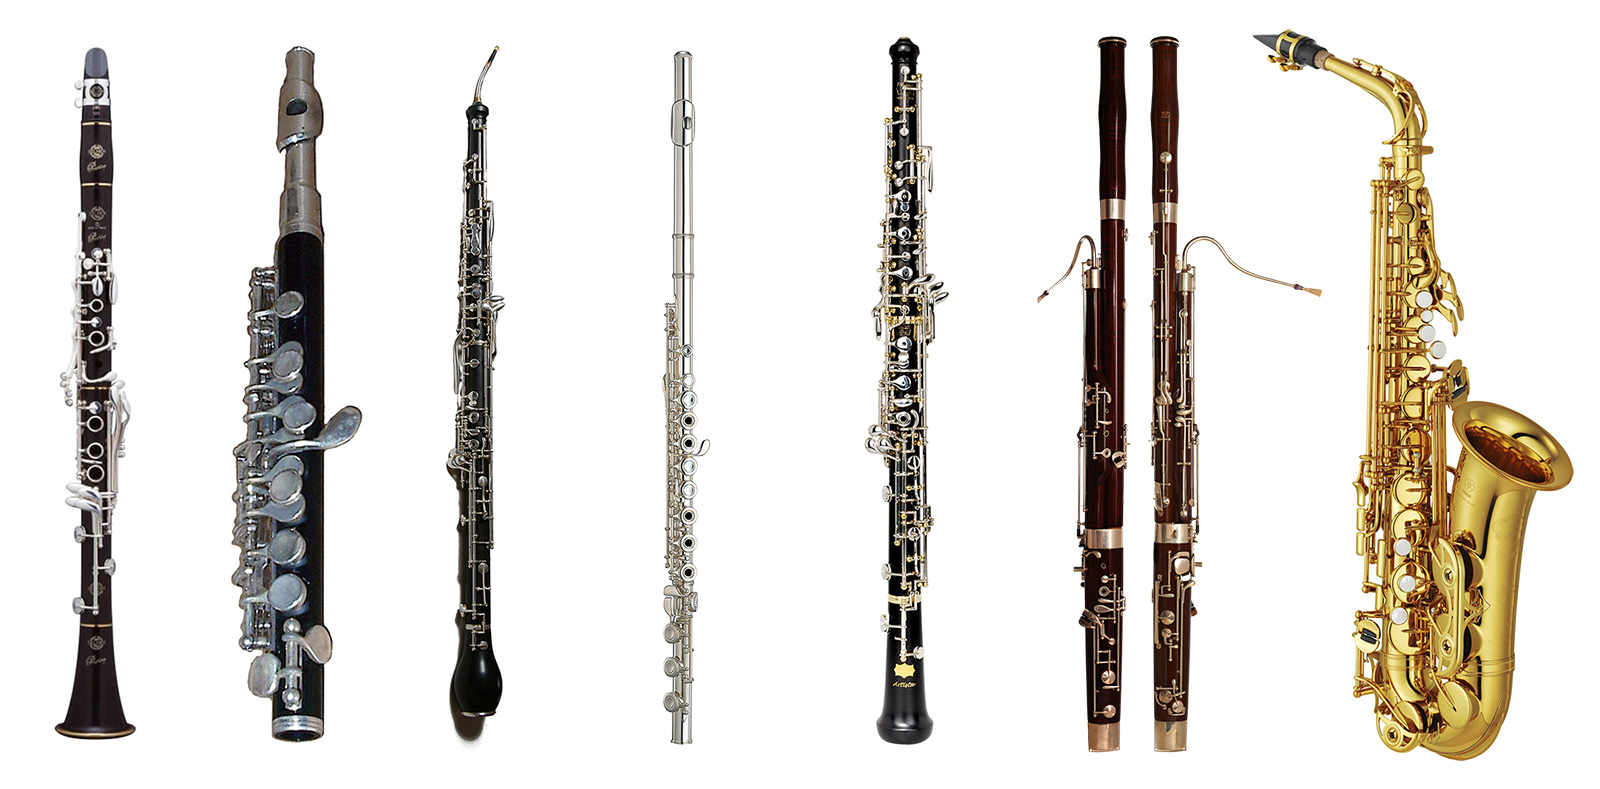
MVSep Woodwind — это высококачественная модель для разделения музыки на деревянные духовые инструменты и всё остальное. Список инструментов: гобой, саксофон, флейта, фагот, кларнет, флейта-пикколо, английский рожок, прочие деревянные духовые.

🗎 Копировать ссылку Use algorithm Demo

MVSep Bagpipes (bagpipes , other)

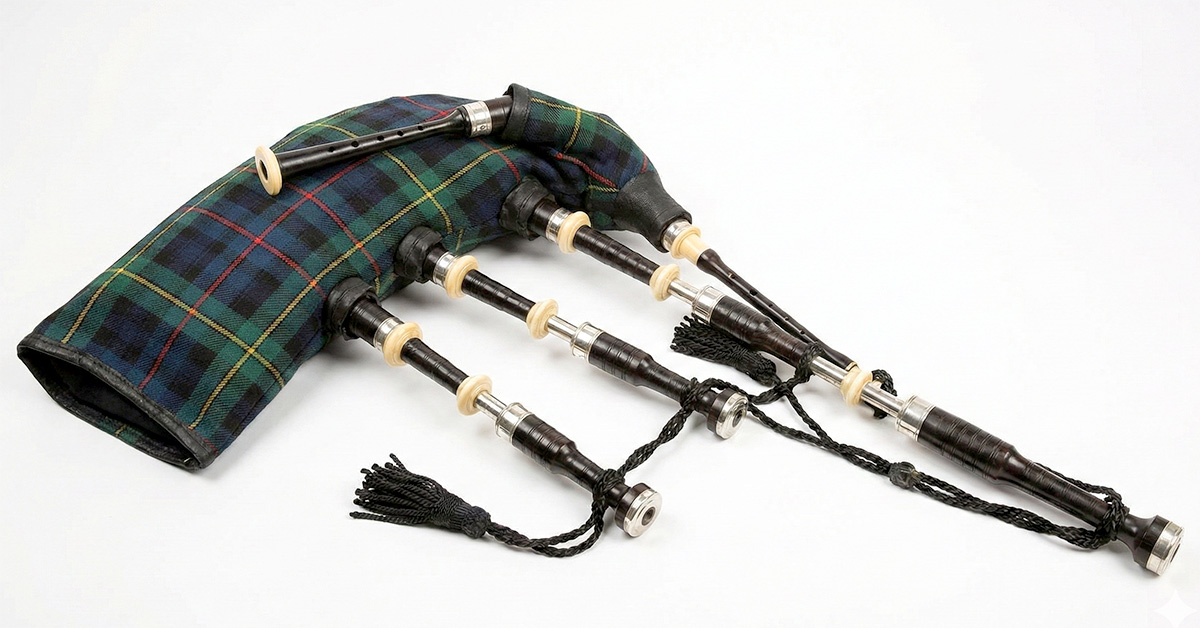
Волынка (Bagpipes) - это традиционный духовой музыкальный инструмент, известный своим характерным пронзительным и непрерывным звучанием.

Как она устроена:

  • Мешок (резервуар): Обычно изготавливается из кожи животных или современных синтетических материалов. Он служит для запаса воздуха.

  • Трубка для вдувания: Через неё музыкант ртом наполняет мешок воздухом (в некоторых разновидностях вместо этого используются небольшие меха, которые качают локтем).

  • Мелодическая трубка (чантер): Трубка с игровыми отверстиями, на которой музыкант перебирает пальцами, исполняя основную мелодию.

  • Бурдонные трубки (дроны): Одна или несколько трубок, которые издают постоянный, тягучий фоновый аккорд на одной ноте.

Главная особенность: Принцип игры заключается в том, что музыкант надувает мешок, а затем давит на него рукой, равномерно выталкивая воздух в звуковые трубки. Благодаря этому резервуару музыка не прерывается, даже когда исполнитель делает вдох.

Хотя волынка чаще всего ассоциируется с Шотландией (Great Highland Bagpipe) и кельтской культурой, её различные исторические вариации существуют по всей Европе, в Северной Африке и на Ближнем Востоке.

🗎 Копировать ссылку Use algorithm Demo

MVSep Percussion (percussion, other)

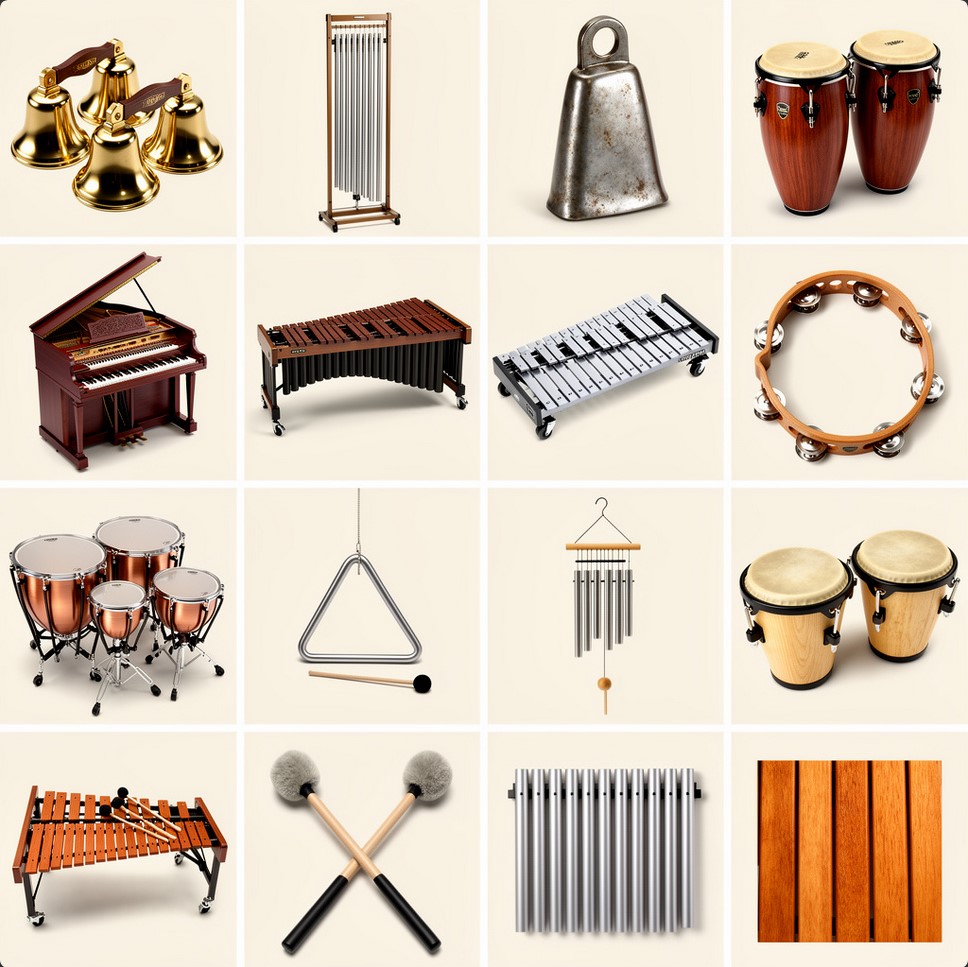
MVSep Percussion — это высококачественная модель для разделения музыки на перкуссию и всё остальное. Список инструментов: колокольчики, трубчатые колокола, коубелл, конги, челеста, маримба, глокеншпиль, бубен, литавры, треугольник, чаймс, бонги, хлопок, ксилофон, колотушки, металлические пластины, деревянные пластины.

🗎 Копировать ссылку Use algorithm Demo

BandIt Plus (speech, music, effects)

Модель BandIt Plus для разделения треков на голос, музыку и эффекты. Она может быть полезна для телевизионных или кинематографических роликов. Модель была выложена авторами статьи "A Generalized Bandsplit Neural Network for Cinematic Audio Source Separation" в репозитории на GitHub. Модель была натренирована на наборе данных Divide and Remaster (DnR). И на данный момент имеет лучшие метрики качества среди подобных моделей.

Таблица качества

Название алгоритма DnR dataset
SDR Speech SDR Music SDR Effects
BandIt Plus 15.62 9.21 9.69
🗎 Копировать ссылку Use algorithm Demo

MVSep DnR v3 (speech, music, effects)

MVSep DnR v3 - это кинематографическая модель для разделения треков на 3 части: музыка, эффекты и диалоги. Она обучена на огромном мультиязыковом датасете DnR v3 и генерирует стемы speech, music и sfx. Метрики качества на проверочных данных получились лучше, чем у аналогичной мультиязыковой модели Bandit v2. Модель доступна в 3 вариантах: на базе архитектур SCNet, MelBand Roformer, а также ансамбль этих двух моделей. См. таблицу ниже:

Название алгоритма
Метрики качества в таблице лидеров DnR v3
music (SDR) sfx (SDR) speech (SDR)
SCNet Large  9.94 11.35 12.59
Mel Band Roformer 9.45 11.24 12.27
Ensemble (Mel + SCNet) 10.15 11.67 12.81
Bandit v2 (для сравнения) 9.06 10.82 12.29
🗎 Копировать ссылку Use algorithm Demo

MVSep Braam

Braam (Браам) - это мощный кинематографический звуковой эффект (виртуальный инструмент), ставший абсолютным стандартом в современной музыке для кино и трейлеров.

Главные особенности:

  • Звучание: Это массивный, низкочастотный, раскатистый и часто агрессивный звук. Он напоминает апокалиптический гудок огромного корабля, тяжелый металлический скрежет или сигнал тревоги.

  • Происхождение: Этот звук приобрел массовую популярность после выхода фильма «Начало» (Inception, 2010) с музыкой Ханса Циммера, из-за чего его часто называют Inception Horn (гудок из «Начала»).

  • Как создается: Как правило, это результат сложного саунд-дизайна. Базой служат мощные низкие медные духовые (тромбоны, тубы, валторны). Затем их наслаивают на тяжелые синтезаторные басы и сильно обрабатывают эффектами: перегрузом (дисторшн), сатурацией и глубокой реверберацией.

Сегодня Braam существует в виде готовых сэмплов и библиотек для виртуальных синтезаторов (VST-плагинов), которые композиторы используют, чтобы мгновенно придать треку масштабность, напряжение или эпичность.

🗎 Копировать ссылку Use algorithm Demo

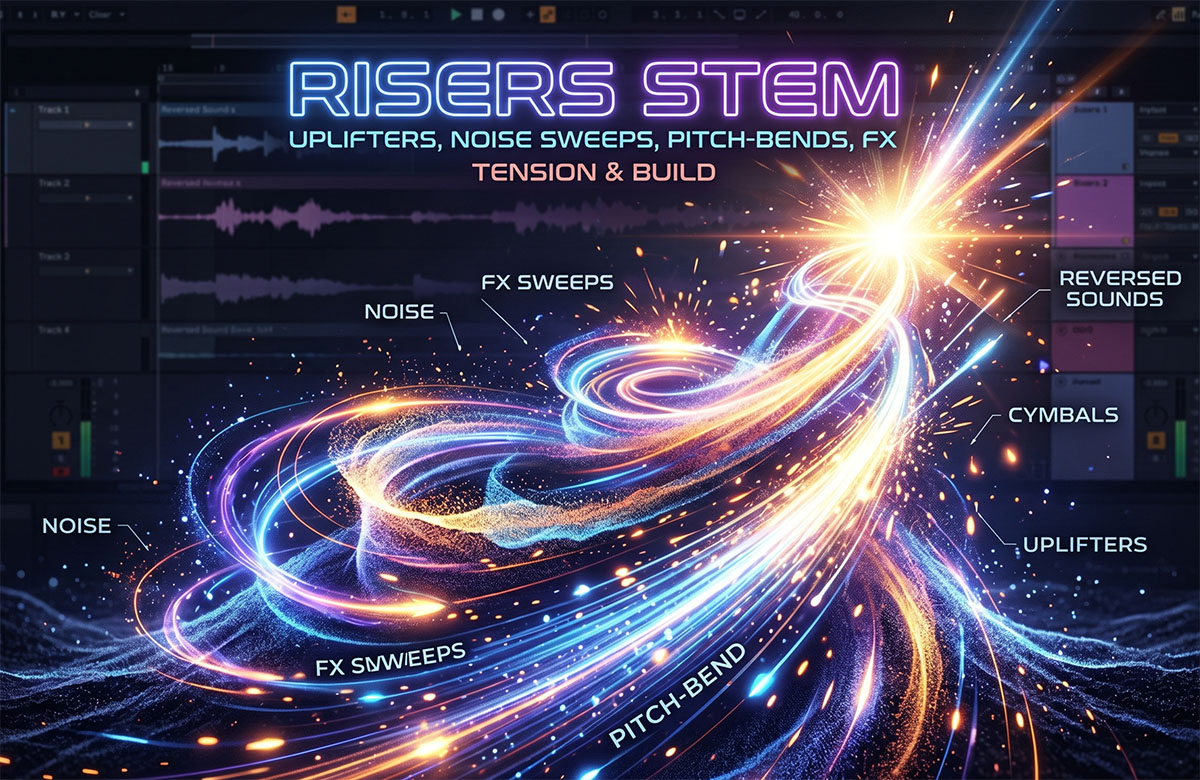
MVSep Risers

Risers (Райзеры) — это дорожка, содержащая звуковые эффекты перехода, которые плавно нарастают по громкости, высоте тона или частотной интенсивности. Их главная задача в треке — создать текстурное напряжение и подготовить слушателя к смене музыкальных частей (например, перед дропом, припевом или кульминацией). В этот стем обычно изолируются следующие элементы: Uplifters и FX-свипы: Синтезаторные или шумовые звуки «разгона». Нарастающий шум: Плавное увеличение громкости белого или розового шума, часто с постепенным открытием фильтра частот (Cutoff). Pitch-bend эффекты: Тональные элементы и синты, частота которых плавно идет вверх. Реверсивные звуки: Перевернутые удары тарелок (reversed cymbals) или длинные «хвосты» реверберации, работающие на нарастание.

🗎 Копировать ссылку Use algorithm Demo

Apollo Enhancers (by JusperLee, Lew, baicai1145)

Алгоритм восстанавливает качество звука. Модель была предложена в этой статье и опубликована на github.

Доступны 3 модели:
1) MP3 Enhancer (автор JusperLee) - восстанавливает файлы MP3, сжатые с битрейтом 32 кбит/с до 128 кбит/с. Он не будет работать для файлов с большим битрейтом.
2) Universal Super Resolution (автор Lew) - восстанавливает более высокие частоты для любой музыки
3) Vocals Super Resolution (автор Lew) - восстанавливает более высокие частоты и общее качество для любого вокала

🗎 Копировать ссылку Use algorithm Demo

Reverb Removal (noreverb)

Набор различных моделей для удаления эффекта реверберации из музыки/вокала.

Author Architecture Works with SDR (no independent testing yet) Link
FoxJoy MDX-B Full track ~6.50  
aufr33 and jarredou MDX23C Full track --- Github
anvuew MelRoformer Only vocals 7.56  
anvuew BSRoformer Only vocals 8.07  
anvuew v2 MelRoformer Only vocals ---  
Sucial MelRoformer Only vocals 10.01  
anvuew BSRoformer Only vocals (Room) 13.74 HF Link
anvuew BSRoformer Only vocals (Stereo) 22.50 HF Link

Тест на нашем внутреннем датасете реверберации ниже:

Модель only vocals vocals drums bass other several
Reverb removal by FoxJoy (MDX-B) 1.2938 8.2146 5.0743 7.2590 8.0154 4.2456
Reverb removal by aufr33 and jarredou (MDX23C) 0.9761 7.3888 4.0913 5.8021 7.7194 3.4537
Reverb removal by anvuew (MelRoformer) 2.3110 2.3029 2.2408 1.8141 2.9739 1.8177
Reverb removal by anvuew (BSRoformer) 2.1902 1.4094 1.4903 1.3958 2.0425 1.2422
Reverb removal by anvuew v2 (MelRoformer) 3.4083 2.3706 1.8884 1.9344 2.6079 1.7384
Reverb removal by Sucial (MelRoformer) 0.1599 0.1750 0.8917 0.9148 0.9803 0.5664
Reverb removal by Sucial v2 (MelRoformer) 0.2052 0.7266 0.9363 --- 1.5508 0.7340
DeReverb room by anvuew (BSRoformer) 2.6593 3.0581 0.0887 1.6156 3.4134 -13.7106
DeReverb stereo by anvuew (BSRoformer) 4.3740 5.3489 5.0900 4.2709 5.3950 4.3072
Reference (SDR between reverb and orig stem) -3.38 4.01 2.35 4.47 4.65 1.04

Тест был подготовлен на основе тестового набора MUSDB18-HQ (50 треков). Сначала все stem-дорожки были очищены от реверберации с помощью модели FoxJoy. Затем были сгенерированы 6 различных тестовых сценариев:

  • Only vocals: Реверберация применялась исключительно к вокальной дорожке, и только эта дорожка использовалась в миксе.

  • Vocals: Реверберация применялась к вокальной дорожке, после чего она объединялась со всеми остальными дорожками для формирования микса.

  • Drums: Реверберация применялась к дорожке ударных, после чего она объединялась со всеми остальными дорожками для формирования микса.

  • Bass: Реверберация применялась к басовой дорожке, после чего она объединялась со всеми остальными дорожками для формирования микса.

  • Other: Реверберация применялась к дорожке «other», после чего она объединялась со всеми остальными дорожками для формирования микса.

  • Several: Реверберация применялась сразу к нескольким дорожкам трека, которые затем объединялись для формирования микса.

Validation dataset 80 треков: реверберация для всех стемов

Model sdr bleedless fullness  l1_freq
Reverb removal by FoxJoy (MDX-B) --- --- --- ---
Reverb removal by anvuew (BSRoformer) 0.89 27.33 4.85 15.03
DeReverb stereo by anvuew (BSRoformer) 4.28 27.29 13.10 23.14
Reverb removal by aufr33 and jarredou (MDX23C) 4.81 23.17 18.65 24.92
Reverb removal by anvuew (MelRoformer) 1.86 28.93 6.62 17.17
Reverb removal by anvuew v2 (MelRoformer) 1.98 30.61 6.86 17.83
Reverb removal by Sucial (MelRoformer) 0.67 40.76 3.98 14.23
Reverb removal by Sucial v2 (MelRoformer) 0.73 35.88 4.28 14.35
DeReverb room by anvuew (BSRoformer) --- --- --- ---
MVSep Team (BSRoformer) 7.87 28.06 26.12 32.33

Validation dataset 27 треков: реверберация только для вокала

Model sdr bleedless fullness l1_freq
Reverb removal by FoxJoy (MDX-B) --- --- --- ---
Reverb removal by anvuew (BSRoformer) 6.67 27.68 13.25 32.32
DeReverb stereo by anvuew (BSRoformer) 8.80 32.84 16.50 37.48
Reverb removal by aufr33 and jarredou (MDX23C) 6.18 16.04 19.32 31.93
Reverb removal by anvuew (MelRoformer) 6.63 29.67 13.14 32.02
Reverb removal by anvuew v2 (MelRoformer) 8.20 29.94 15.91 36.13
Reverb removal by Sucial (MelRoformer) 4.88 31.56 11.13 27.90
Reverb removal by Sucial v2 (MelRoformer) 4.94 27.85 11.39 28.14
MVSep Team (BSRoformer) 9.81 29.23 18.56 40.33

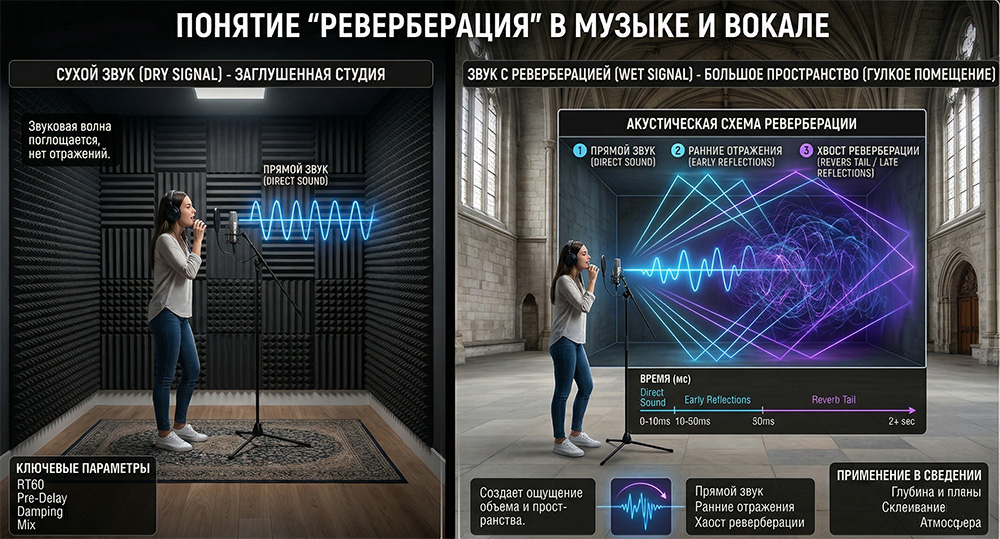
Реверберация (Reverb) - это физический процесс постепенного затухания звука в закрытом пространстве после того, как источник звука замолчал. Если обычное эхо - это отчетливые, раздельные копии звука (как крик в горах: "Ау... ау... ау"), то реверберация — это плотное, непрерывное гудящее облако из тысяч слившихся воедино отражений от стен, пола, потолка и других поверхностей (как звук хлопка в пустом соборе или на лестничной клетке).

В звукорежиссуре эффект реверберации используется для того, чтобы поместить сухой (записанный в студии) звук в какое-либо виртуальное пространство и придать ему объем.

Из чего состоит реверберация?

Акустически этот процесс можно разделить на три этапа:

  1. Прямой звук (Direct Sound): Звуковая волна, которая доходит до слушателя или микрофона по прямой линии, без каких-либо отражений. Это самый громкий и четкий сигнал.

  2. Ранние отражения (Early Reflections): Первые отзвуки, которые отразились от ближайших поверхностей и достигли ушей спустя несколько миллисекунд после прямого звука. Именно они дают нашему мозгу информацию о том, в помещении какого размера и формы мы находимся.

  3. Хвост (Late Reflections / Reverb Tail): Множество хаотичных, переплетающихся отражений, которые отскакивают от поверхностей снова и снова. Они сливаются в сплошной гул и постепенно теряют энергию (затухают).

Основные параметры в плагинах реверберации

Когда вы открываете плагин реверберации в DAW (цифровой звуковой рабочей станции), вы управляете физическими свойствами этого виртуального помещения:

  • Size / Room Size (Размер): Задает объем виртуального пространства (от крошечной кабинки до огромного стадиона).

  • Decay / Reverb Time / RT60 (Время затухания): Время (обычно в секундах), за которое хвост реверберации затухает на 60 децибел, то есть практически исчезает.

  • Pre-Delay (Предзадержка): Очень важный параметр, задающий паузу (в миллисекундах) между прямым звуком и началом реверберации. Увеличение Pre-Delay помогает отделить вокал или инструмент от "хвоста", сохраняя их разборчивость, но при этом оставляя ощущение большого пространства.

  • Damping (Демпфирование): Имитирует поглощение звука. В реальной жизни мягкие поверхности (ковры, люди, шторы) быстро поглощают высокие частоты, поэтому длинный хвост реверберации обычно звучит глуше прямого сигнала.

  • Mix / Dry/Wet (Баланс): Соотношение между исходным сухим сигналом (Dry) и обработанным (Wet).

Зачем нужна реверберация при сведении музыки?

  • Создание планов (глубина): Реверберация работает как ось Z (глубина) в миксе. Громкий и сухой звук кажется слушателю близким (прямо перед лицом), а тихий звук с большим количеством реверберации — далеким.

  • Склеивание микса: Если все инструменты записаны в разных заглушенных студиях, микс может звучать разрозненно. Отправка их на общую шину реверберации (даже в небольших количествах) помещает их в одно акустическое пространство.

  • Художественный эффект: Создание неземной, эмбиентной или эпичной атмосферы (например, эффект Shimmer, где хвост реверберации еще и поднимается на октаву вверх).

Зачем нужно удалять эффект реверберации?

Удаление реверберации (или дереверберация) — это процесс очистки аудиосигнала от акустических отражений помещения, чтобы получить изначальный сухой (Dry) звук. Хотя реверберация делает звук красивым и объемным, во многих профессиональных сценариях этот эффект превращается в нежелательный шум или серьезное препятствие. Вот главные причины, почему возникает необходимость «высушить» звук:

  • Разделение музыкальных источников (Source Separation): При извлечении вокала или отдельных инструментов из готового стереотрека хвосты реверберации создают серьезную проблему — они «въедаются» в полезный сигнал. Эффективная дереверберация позволяет получить по-настоящему чистую акапеллу или стем инструмента, которые звучат так, будто их только что записали в студии, а не вырезали из концертного зала.

  • Системы автоматического распознавания речи (ASR): Эхо и гул помещения — злейшие враги акустических моделей. Отражения «размазывают» короткие согласные звуки и фонемы. В сложных задачах машинного обучения, таких как создание моделей распознавания детской речи, где артикуляция и без того часто бывает нечеткой, наличие реверберации катастрофически снижает точность транскрибации. Поэтому дереверберация является критически важным шагом предобработки аудио-датасетов.

  • Сэмплирование и ремикширование: Если вы берете вокальный сэмпл или барабанный луп со старой записи, он уже содержит пространство оригинального микса. Если добавить этот сэмпл в свой трек и наложить поверх него собственный, новый ревербератор, возникнет акустическая «грязь» (эффект реверберации на реверберации). Чтобы интегрировать чужой звук в свою архитектуру микса, его сначала нужно очистить.

  • Постпродакшн видео и кино (ADR & Location Sound): Речь актеров часто записывается микрофонами-пушками прямо на съемочной площадке (например, в гулкой пустой комнате или на лестничной клетке). Чтобы диалог звучал плотно, разборчиво и студийно, звукорежиссеру необходимо подавить естественные отражения локации.

  • Реставрация и форензика (криминалистика): Записи с камер наблюдения, скрытых микрофонов или диктофонов часто содержат столько комнатного гула, что слова становятся неразборчивыми. Подавление реверберации помогает восстановить читаемость речи.

Как это работает технологически? Раньше звукорежиссеры пытались бороться с комнатой с помощью гейтов (Noise Gate) и транзиент-шейперов (Transient Shaper), которые просто обрезали тихие хвосты звуков. Это работало грубо и часто искажало сам полезный сигнал. Сегодня задача дереверберации решается с помощью ИИ и нейронных сетей, которые обучены анализировать спектрограмму, отличать паттерны прямого сигнала от паттернов отражений и математически вычитать последние без ущерба для оригинала.

🗎 Копировать ссылку Use algorithm Demo

AudioSR (Super Resolution)

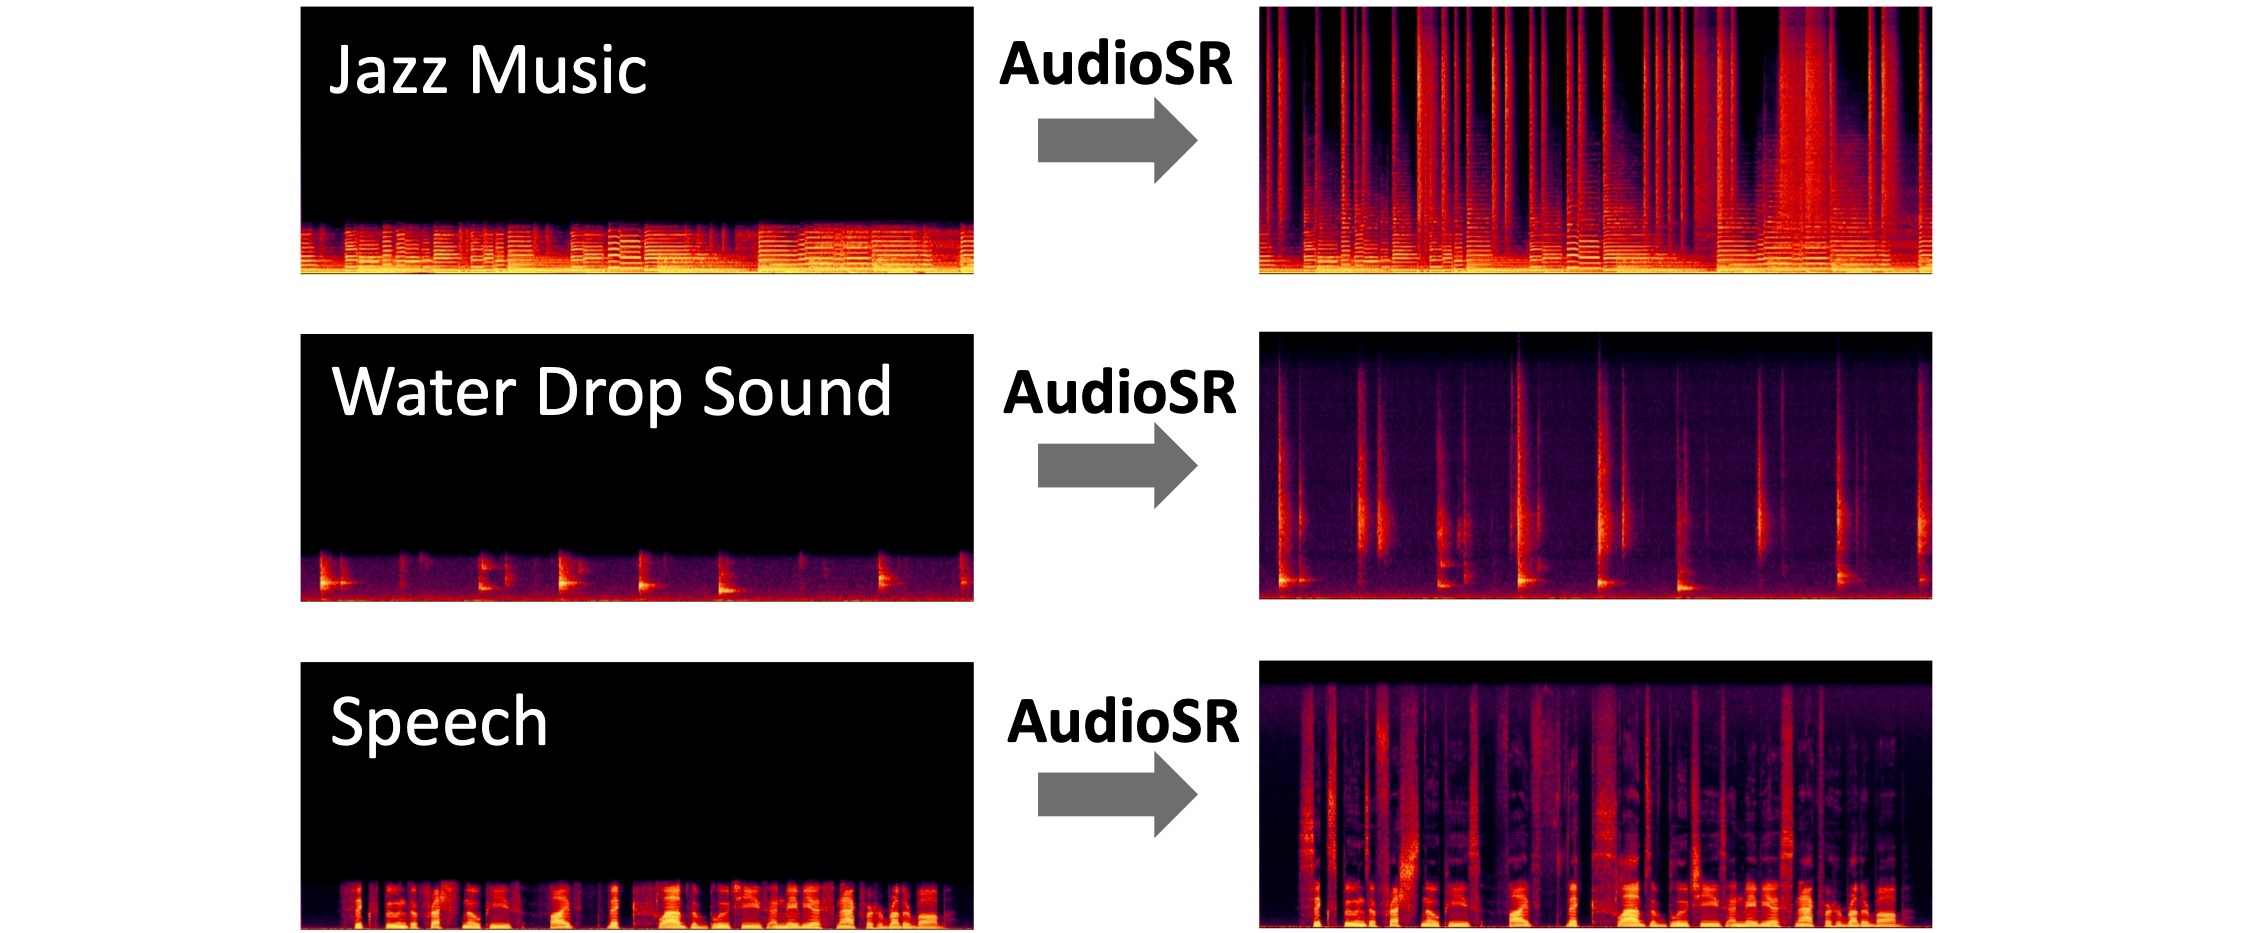
Алгоритм AudioSR: Универсальное масштабируемое аудио супер-разрешение. Алгоритм восстанавливает высокие частоты. Он работает со всеми типами аудио (например, музыка, речь, лай собаки, звук дождя и т.д.). Изначально он был обучен на монофоническом аудио, поэтому может давать нестабильные результаты на стерео.

Метрика на Super Resolution Checker for Music Leaderboard (Restored): 25.3195
Статья авторов: https://arxiv.org/pdf/2309.07314
Оригинальный репозиторий: https://github.com/haoheliu/versatile_audio_super_resolution
Оригинальный скрипт для вывода, подготовленный @jarredou: https://github.com/jarredou/AudioSR-Colab-Fork

🗎 Копировать ссылку Use algorithm Demo

FlashSR (Super Resolution)

FlashSR — алгоритм супер-разрешения аудио для восстановления высоких частот. Основан на статье FlashSR: One-step Versatile Audio Super-resolution via Diffusion Distillation. 

Метрика на Super Resolution Checker for Music Leaderboard (Restored): 22.1397
Оригинальный репозиторий: https://github.com/jakeoneijk/FlashSR_Inference
Скрипт для инференса от @jarredou: https://github.com/jarredou/FlashSR-Colab-Inference

🗎 Копировать ссылку Use algorithm Demo

Stable Audio Open Gen 1.0

Генерация аудио по заданному текстовому запросу. Для генерации используется модель Stable Audio Open 1.0. Аудио генерируется в формате Стерео с частотой дискретизации 44.1 kHz длинной до 47 секунд. Качество довольно высокое. Запросы лучше делать на английском языке.

Примеры запросов:
1) Генерация отдельных звуков: cats meow, lion roar, dog bark
2) Генерация отдельных семплов: 128 BPM tech house drum loop
3) Генерация конкретных инструментов: A Coltrane-style jazz solo: fast, chaotic passages (200 BPM), with piercing saxophone screams and sharp dynamic changes

🗎 Копировать ссылку Use algorithm Demo

Whisper (extract text from audio)

Whisper — это модель нейронной сети автоматического распознавания речи (ASR) и перевода речи от компании OpenAI. Модель имеет несколько версий. На MVSep мы используем самую большуюю и точную: «Whisper large-v3». Модель Whisper large-v3 была обучена на нескольких миллионах часов аудио. Это многоязычная модель, и она автоматически умеет определять язык текста. Чтобы применить модель к вашему аудио, у вас есть 2 варианта:
1) «Apply to original file» — это означает, что модель шепота будет применена непосредственно к отправленному вами файлу. 
2) «Extract vocals first» — в этом случае перед использованием шепота сначала применяется модель BS Roformer для извлечения вокала. Она может удалить ненужный шум, чтобы улучшить качество работы Whisper.

У исходной модели были некоторые проблемы с таймингами транскрипции. Это было исправлено @linto-ai. Его вариант транскрипции доступен c опцией "New timestamps by linto-ai", но иногда этот метод может давать нежелательные артифакты. Оригинальный вариант таймингов доступен по опции "Old version of timestamps by whisper".

Более подробную информацию о модели можно найти здесь: https://huggingface.co/openai/whisper-large-v3 и здесь: https://github.com/openai/whisper


🗎 Копировать ссылку Use algorithm Demo

Parakeet (extract text from audio)

Parakeet — это семейство передовых моделей автоматического распознавания речи (ASR), разработанных NVIDIA совместно с Suno.ai. Эти модели построены на архитектуре Fast Conformer, созданной для обеспечения баланса между высокой точностью транскрипции и исключительной скоростью инференса. Они широко известны тем, что превосходят гораздо более крупные модели (такие как Whisper от OpenAI) по эффективности, сохраняя при этом конкурентоспособные или лучшие показатели ошибок слов (WER). Метрика качества WER: 6.03 в рейтинге Huggingface Open ASR.

MVSep предоставляет две версии модели (v2 и v3):
Страница модели v2: https://huggingface.co/nvidia/parakeet-tdt-0.6b-v2
Страница модели v3: https://huggingface.co/nvidia/parakeet-tdt-0.6b-v3


Parakeet v2 (Parakeet TDT 0.6B v2)

Выпущенная как высокоэффективная модель, ориентированная на английский язык, v2 утвердила Parakeet в качестве лидера по соотношению скорости и точности.

  • Язык: Только английский (en-US).
  • Размер: 0,6 миллиарда параметров (600 млн), что делает её легковесной по сравнению с 1,1 млрд параметров в предыдущих версиях.
  • Производительность: Достигает ведущей в отрасли точности (около 6% WER на стандартных тестах) и работает до 50 раз быстрее реального времени.
  • Возможности:
    • Поддерживает высокоточные таймкоды на уровне слов.
    • Включает автоматическую пунктуацию и капитализацию (простановку заглавных букв).
    • Эффективна при транскрипции неречевых звуков, таких как тексты песен и произносимые числа.
    • Может обрабатывать длинные аудиозаписи (до 11 часов в некоторых конфигурациях), используя механизмы локального внимания.

Parakeet v3 (Parakeet TDT 0.6B v3)

Выпуск v3 ознаменовал расширение эффективной архитектуры Parakeet с исключительно английского языка на многоязычную область без увеличения размера модели.

  • Язык: Многоязычная (поддерживает 25 европейских языков, включая английский, испанский, французский, немецкий, русский и другие).
  • Размер: Сохраняет компактный размер в 0,6 миллиарда параметров.
  • Ключевое обновление: Обучена на огромном многоязычном корпусе Granary (около 1 миллиона часов аудио).
  • Новые функции:
    • Автоматическое определение языка: Модель может определять язык речи по аудиосигналу и транскрибировать его без ручных подсказок.
    • Высокая пропускная способность: Несмотря на добавленные многоязычные возможности, она сохраняет сверхбыструю скорость инференса архитектуры v2 TDT.
    • Универсальность: Служит прямой заменой для v2 для пользователей, которым требуется поддержка европейских языков при сохранении низкой задержки и вычислительных затрат.

🗎 Копировать ссылку Use algorithm Demo

Qwen3-ASR (extract text from audio)

Qwen3-ASR - модель распознавания речи (speech-to-text) с открытым исходным кодом от команды Qwen, построенная на основе аудиовозможностей Qwen3-Omni. Она преобразует речь, пение или песню в текст с пунктуацией и временными метками. На MVSep используется самая большая версия модели (Qwen3-ASR-1.7B) вместе с Qwen3-ForcedAligner-0.6B, которая привязывает каждое распознанное слово ко времени в записи.

Модель распознаёт 30 языков и 22 китайских диалекта и определяет язык автоматически. В отличие от большинства моделей распознавания речи, она обучена работать с пением и песнями с музыкальным сопровождением, поэтому хорошо подходит для получения текстов песен. Результат — полный текст и список сегментов (предложений или фраз) с временем начала и окончания.

Настройки

  • Сначала выделить вокал - перед распознаванием отделить вокал от музыки. Рекомендуется для песен с громкими инструментами. Для записей речи обычно не требуется. Если на исходной записи не удаётся определить время слов, вокал выделяется автоматически.
  • Язык - оставьте «авто» для автоматического определения или выберите язык явно, если в записи несколько языков или язык определяется неверно.

Поддерживаемые языки

английский, китайский, кантонский, арабский, немецкий, французский, испанский, португальский, индонезийский, итальянский, корейский, русский, тайский, вьетнамский, японский, турецкий, хинди, малайский, нидерландский, шведский, датский, финский, польский, чешский, филиппинский, персидский, греческий, румынский, венгерский, македонский, а также 22 китайских диалекта.

Временные метки официально поддерживаются для 11 языков: английского, китайского, кантонского, французского, немецкого, итальянского, японского, корейского, португальского, русского и испанского. Для остальных языков временные метки могут быть менее точными.

Качество

Доля ошибок в словах (WER, %, чем меньше, тем лучше), опубликованная авторами:

Набор данных Whisper-large-v3 Qwen3-ASR-1.7B
LibriSpeech (clean / other) 1.51 / 3.97 1.63 / 3.38
Fleurs (английский) 4.08 3.35
Common Voice (английский) 9.90 7.39
Fleurs (12 языков) 5.27 4.90
MLS (8 языков) 8.62 8.55
M4Singer (пение) 13.58 5.98
Popcs (пение) 13.77 8.52

Точность определения языка: 97.9% (Whisper-large-v3: 94.1%).

Ссылки

  • Оригинальная страница: github.com/QwenLM/Qwen3-ASR
  • Веса модели: huggingface.co/Qwen/Qwen3-ASR-1.7B, huggingface.co/Qwen/Qwen3-ForcedAligner-0.6B
  • Статья: Qwen3-ASR Technical Report (2026)

© Qwen Team, Alibaba Cloud. Лицензия: Apache 2.0

🗎 Копировать ссылку Use algorithm Demo

VibeVoice (Voice Cloning)

VibeVoice — это модель для генерации естественных разговорных диалогов из текста с возможностью использовать эталонный голос с целью его клонирования.

Основные возможности:

  • Две модели: маленькая и большая
  • До 90 минут сгенерированного аудио
  • Поддержка языков: поддерживается 2 языка: английский (по умолчанию) и китайский
  • Клонирование голоса: возможность загрузить эталонную аудиозапись

Как использовать модель

  • Текст должен быть только на английском или китайском языке, для других языков качество не гарантируется. Максимальная длина текста 5000 символов. Избегайте специальных символов. 
  • Аудио с эталонным голосом требуется от 5 до 15 секунд. Если ваш трек длиннее, то он будет автоматически обрезан на 15 секунде. 
  • Эталонный трек должен содержать только голос и ничего лишнего. Если у вас есть посторонние звуки или музыка используйте опцию "Extract vocals first".

Как сгенерировать эталонный трек?

Нам нужно фонетическое разнообразие (все звуки языка) и живая интонация. Текст длиной около 35–40 слов при спокойном чтении как раз займет ~15 секунд.

Вот три варианта на английском под разные задачи:

Option 1: Universal (Balanced & Clear)

Лучший выбор для общего использования. Содержит сложные звукосочетания для настройки четкости.

"To create a perfect voice clone, the AI needs to hear a full range of phonetic sounds. I am speaking clearly, taking small pauses, and asking: can you hear every detail? This short sample captures the unique texture and tone of my voice."

Option 2: Conversational (Vlog & Social Media)

Для озвучки роликов, YouTube или блогов. Читайте живо, с улыбкой, меняя высоту голоса.

"Hey! I’m recording this clip to test how well the new technology works. The secret is to relax and speak exactly like I would to a friend. Do you think the AI can really copy my style and energy in just fifteen seconds?"

Option 3: Professional (Business & Narration)

Для презентаций, аудиокниг или официальных сообщений. Читайте уверенно, немного медленнее, выделяя окончания слов.

"Voice synthesis technology is rapidly changing how we communicate in the digital age. It is essential to speak with confidence and precision to ensure high-quality output. This brief recording provides all the necessary data for a professional and accurate digital clone."


Советы для записи на английском (Tips for recording):

  1. Pronunciation (Произношение): Старайтесь четко проговаривать окончания слов (особенно t, d, s, ing). Модели "любят" четкую артикуляцию.

  2. Flow (Поток): Не читайте как робот. В английском важна мелодика (voice melody) — голос должен немного "плавать" вверх и вниз, а не звучать на одной ноте.

  3. Breathing (Дыхание): Если вы делаете паузу на запятой или точке, не бойтесь сделать слышный вдох. Это добавит реализма клону.

🗎 Копировать ссылку Use algorithm Demo

VibeVoice (TTS)

VibeVoice (TTS) — это модель для генерации естественных разговорных диалогов из текста с возможностью создавать диалоги до 4 собеседников и длительностью до 90 минут.

Основные возможности:

  • Две модели: маленькая и большая
  • До 4 говорящих в одной записи
  • До 90 минут сгенерированного аудио
  • Поддержка языков: официально поддерживается 2 языка: английский (по умолчанию) и китайский, но проверено что сносно работает и для других языков.

Как использовать модель

Текст должен быть на английском или китайском языке, для других языков качество не гарантируется. Максимальная длина текста 5000 символов. Избегайте специальных символов. Текст должен быть оформлен в специальном формате с указанием говорящих:

Правильный формат:

Speaker 1: Hello! How are you today?
Speaker 2: I'm doing great, thanks for asking!
Speaker 1: That's wonderful to hear.
Speaker 3: Hey everyone, sorry I'm late!

Неправильный формат:

Hello! How are you today?
I'm doing great!

Важно:

  • Каждая реплика должна начинаться с Speaker N: (где N — номер от 1 до 4)
  • Нумерация говорящих: Speaker 1, Speaker 2, Speaker 3, Speaker 4
  • Можно использовать от 1 до 4 говорящих
  • Регистр не важен: Speaker 1: = speaker 1: = SPEAKER 1

Если вам нужен монолог, то спикера можно не указывать.

Примеры сценариев:

Монолог (1 говорящий):

Speaker 1: Today I want to talk about artificial intelligence. 
Speaker 1: It's changing our world in incredible ways.
Speaker 1: From healthcare to entertainment, AI is everywhere.

Диалог (2 говорящих):

Speaker 1: Have you tried the new restaurant downtown?
Speaker 2: Not yet, but I've heard great things about it!
Speaker 1: We should go there this weekend.
Speaker 2: That sounds like a perfect plan!

Групповая беседа (3-4 говорящих):

Speaker 1: Welcome to our podcast, everyone!
Speaker 2: Thanks for having us!
Speaker 3: It's great to be here.
Speaker 4: I'm excited to share our thoughts today.
Speaker 1: Let's start with introductions.
🗎 Копировать ссылку Use algorithm Demo

Qwen3-TTS (Custom Voice)

Qwen3-TTS — это мощная модель генерации речи, предлагающая поддержку клонирования голоса, дизайна голоса, создания сверхкачественной человекоподобной речи и управления голосом на естественном языке. Она предоставляет разработчикам и пользователям самый широкий набор функций генерации речи. На MVSep мы используем самую большую модель с 1,7 млрд параметров.

Страница оригинальной модели: https://github.com/QwenLM/Qwen3-TTS

Qwen3-TTS (Custom Voice) предлагает набор из 9 предустановленных дикторов. Дополнительно вы можете указать «Voice description» (описание голоса), добавив эмоции, например «happy voice» (счастливый голос) или «sad voice» (грустный голос). Вы также можете выбрать язык для этой модели или оставить значение «auto».

🗎 Копировать ссылку Use algorithm Demo

Qwen3-TTS (Voice Design)

Qwen3-TTS — это мощная модель генерации речи, предлагающая поддержку клонирования голоса, дизайна голоса, создания сверхкачественной человекоподобной речи и управления голосом на естественном языке. Она предоставляет разработчикам и пользователям самый широкий набор функций генерации речи. На MVSep мы используем самую большую модель с 1,7 млрд параметров.

Страница оригинальной модели: https://github.com/QwenLM/Qwen3-TTS

Qwen3-TTS (Voice Design) предлагает начитать текст произвольным голосом, который можно подробно описать в поле «Voice description» (описание голоса). Можно указать пол и возраст диктора, добавить эмоции, например «happy voice» (счастливый голос) или «sad voice» (грустный голос). Вы также можете выбрать язык для этой модели или оставить значение «auto».

🗎 Копировать ссылку Use algorithm Demo

Qwen3-TTS (Voice Cloning)

Qwen3-TTS — это мощная модель генерации речи, предлагающая поддержку клонирования голоса, дизайна голоса, создания сверхкачественной человекоподобной речи и управления голосом на естественном языке. Она предоставляет разработчикам и пользователям самый широкий набор функций генерации речи. На MVSep мы используем самую большую модель с 1,7 млрд параметров.

Страница оригинальной модели: https://github.com/QwenLM/Qwen3-TTS

Qwen3-TTS (Voice Cloning) позволяет загрузить референсный аудиофайл, чтобы озвучить заданный текст голосом из образца. Для повышения качества клонирования вы можете дополнительно указать расшифровку аудио в поле «Reference text in audio». Вы также можете выбрать язык для этой модели или оставить значение «auto».

🗎 Копировать ссылку Use algorithm Demo

Mega 53-stem Model

Поддерживаемые инструменты: аккордеон, акустическая гитара, бэк-вокал, банджо, бас, фагот, колокольчики, смычковые струнные, медные духовые, виолончель, кларнет, конги, цифровое пианино, добро, контрабас, барабаны, электрогитара, флейта, валторна, глокеншпиль (металлофон), гитара, губная гармоника, арфа, клавесин, хэт (хай-хэт), клавишные, бочка (бас-барабан), лидирующий вокал, мандолина, маримба, гобой, орган, перкуссия, пианино, саксофон, ситар, малый барабан (рабочий барабан), струнные, синтезатор, тамбурин (бубен), литавры, томы, треугольник, тромбон, труба, туба, укулеле, альт, скрипка, вокал, духовые, ветряные колокольчики (марка дерева), деревянные духовые.

Замечание 1: Модель выводит только те инструменты, которые были обнаружены в музыкальной композиции. Инструменты, отсутствующие в треке, не выводятся.

Замечание 2: Индивидуальные модели для каждого инструмента в большинстве случаев показывают результат лучше, чем данная мультимодель. Поэтому рекомендуется использовать её для определения набора стемов, а затем извлекать их с помощью отдельных инструментальных моделей, обученных на более узких задачах.

Замечание 3: Для сокращения места на диске результаты сохраняются во все форматы кроме WAV (вместо WAV будет  FLAC).

Замечание 4: Эта модель отличается от ранее опубликованной нами открытой модели и является её усовершенствованной версией. Ниже приведена сравнительная таблица:

Instrument SDR открытой модели SDR новой модели Дельта SDR
accordion 6,2494 6,6498 +0,4004
acoustic-guitar 5,0024 5,0797 +0,0773
back-vocal 6,4179 6,5262 +0,1083
banjo 3,1593 3,7532 +0,5939
bass 11,1680 11,2886 +0,1206
bassoon 4,6595 5,1663 +0,5068
bells 1,1190 4,8040 +3,6850
bowed_strings 12,4486 12,4486 0,0000
brass 6,7042 6,8487 +0,1445
cello 5,0364 5,2257 +0,1893
clarinet 5,0505 5,8690 +0,8185
congas 9,1747 9,5946 +0,4199
digital-piano 7,9634 9,0179 +1,0545
dobro 7,6562 8,2290 +0,5728
double-bass 14,1731 15,6032 +1,4301
drums 9,2502 11,4520 +2,2018
electric-guitar 8,1543 8,1856 +0,0313
flute 6,2134 6,8557 +0,6423
french-horn 5,2635 5,5136 +0,2501
glockenspiel 3,6621 8,1523 +4,4902
guitar 2,5661 2,6164 +0,0503
harmonica 10,9265 11,8575 +0,9310
harp 6,3767 7,6523 +1,2756
harpsichord 1,6090 1,9524 +0,3434
hh 2,4681 3,2904 +0,8223
keys 9,3032 9,3106 +0,0074
kick 11,5485 11,5485 0,0000
lead-vocal 5.4663 5.4663 0,0000
mandolin 4,4256 4,7735 +0,3479
marimba 4,4821 4,8830 +0,4009
oboe 3,3616 4,5555 +1,1939
organ 10,3684 10,8244 +0,4560
percussion 2,5008 2,8897 +0,3889
piano 6,7787 6,8080 +0,0293
saxophone 8,8875 9,4985 +0,6110
sitar 4,6529 5,0434 +0,3905
snare 6,1338 6,7784 +0,6446
strings 8,8151 8,8151 0,0000
synth 2,0539 2,0539 0,0000
tambourine 3,0589 3,5544 +0,4955
timpani 4,6423 4,9779 +0,3356
toms -2,0607 -1,0708 +0,9899
triangle 5,9274 6,0197 +0,0923
trombone 2,6949 3,0751 +0,3802
trumpet 4,9658 5,8668 +0,9010
tuba 7,1957 7,5229 +0,3272
ukulele 6,7869 6,9721 +0,1852
viola 1,8581 1,8581 0,0000
violin 3,1018 3,3285 +0,2267
vocal 11,6590 11,6590 0,0000
wind 8,6317 8,6632 +0,0315
wind-chimes 4,6440 6,7529 +2,1089
woodwind 3,3123 3,3224 +0,0101
🗎 Копировать ссылку Use algorithm Demo

Upmixing by Jazzpear

Данная нейросетевая модель предназначена для высококачественного преобразования стереофонического аудио в пространственный звук. Она оптимизирована для работы с музыкой и кинематографическим контентом (фильмы, сериалы, аниме) и автоматически разделяет исходный стереосигнал на 4 независимых стэма. Так же автоматически производится многоканальное сведение результата. 

Разделение на каналы (Stems)

Алгоритм генерирует четыре базовые дорожки:

  • LR (Front): Фронтальное стерео

  • S (Sides): Боковое (тыловое) стерео

  • LFE (Sub): Низкочастотный канал (сабвуфер)

  • C (Center): Центральный фронтальный канал

Преимущества и технологии

В отличие от традиционных методов конвертации стерео в surround, которые полагаются на базовое Mid/Side-разделение и часто выдают грязный или неестественный звук, эта модель обучена на нативных 5.1 и 6-канальных миксах, предварительно разбитых на стэмы.

Благодаря этому алгоритм «понимает» естественную физику распределения звука и перетекание частот в пространстве:

  • Идеальный центральный канал: Сухие диалоги, вокал по центру и моно-эффекты изолируются кристально чисто — без характерного «жестяного» призвука или грязи от соседних каналов.

  • Глубокое стереополе: Широкий вокал, атмосферные SFX и инструменты аккуратно распределяются между фронтальными и тыловыми стереопарами, создавая по-настоящему иммерсивное звучание.

Ограничения

Для корректной работы алгоритма требуется полноценный стереосигнал.

  • Mono (1ch): Не поддерживается.

  • Dual-Mono (2ch): Строго не рекомендуется. Обработка такого аудио приведет к сильным искажениям звуковой картины и некорректному позиционированию элементов в пространстве.

🗎 Копировать ссылку Use algorithm Demo

DeEffect vocals by gilliaan

Эта модель удаления эффектов и извлечения вокала предназначена для восстановления чистого, сухого основного вокала из обработанных записей. Она эффективно удаляет реверберацию, задержки/эхо, дабл-треки и проникновение бэк-вокала, одновременно подавляя инструментальные дорожки. Модель поддерживает как стерео, так и моно эффекты. Хотя она в первую очередь оптимизирована для основного вокала, она также может обрабатывать бэк-вокал, если каналы разделены заранее.

По сути, модель объединяет методы дереверберации, подавления эха, удаления вокального проникновения и изоляции вокала для извлечения чистого исходного сухого вокального сигнала.

Создано @gilliaan

🗎 Копировать ссылку Use algorithm Demo

Bark (Speech Gen)

Bark — это созданная компанией Suno модель на базе архитектуры трансформеров, которая представляет собой не просто традиционный инструмент синтеза речи, а полноценную генеративную систему класса «текст в аудио». Её возможности выходят далеко за рамки обычного озвучивания: помимо создания высокореалистичной речи на множестве языков, Bark умеет генерировать музыку, фоновые шумы и простые звуковые эффекты. Уникальной особенностью модели является способность воспроизводить тонкие невербальные коммуникации, такие как смех, вздохи и плач, что делает итоговое звучание максимально живым и естественным.

Стремясь поддержать сообщество, разработчики открыли доступ к предварительно обученным контрольным точкам, которые готовы к работе и разрешены даже для коммерческого использования. Тем не менее важно учитывать, что Bark создавался в первую очередь для исследовательских задач. Будучи полностью генеративной моделью, она может вести себя непредсказуемо и иногда отклоняться от введенных текстовых подсказок.

Официальный репоизторий модели: https://github.com/suno-ai/bark

В отличие от классических TTS-систем, Bark не использует SSML-разметку. Вместо этого он обучен распознавать определенные текстовые вставки (теги) как инструкции для генерации звуков.

Инструкция по кодированию эмоций и звуков в Bark

1. Основной принцип

Все управляющие команды пишутся в квадратных скобках. Важно: Сами теги должны быть написаны на английском языке, даже если основной текст, который вы генерируете, на русском, испанском или любом другом языке.

Синтаксис:

Текст до эффекта [тег_эффекта] текст после эффекта.

2. Список поддерживаемых тегов (Non-speech sounds)

Bark официально распознает следующий набор токенов для невербальных звуков:

Тег Описание Пример использования
[laughter] Громкий, явный смех Привет! [laughter] Как же это было смешно.
[laughs] Короткий смешок, хихиканье Ну да, конечно [laughs].
[sighs] Тяжелый вздох (усталость, облегчение) [sighs] Я так устал от этой работы.
[music] Вставка инструментальной музыки [music] (играет фоновая музыка)
[gasps] Резкий вдох (испуг, удивление) [gasps] Я не ожидал тебя здесь увидеть!
[clears throat] Откашливание (привлечение внимания) [clears throat] Господа, прошу внимания.

Примечание: Также существуют вариации [man laughs] и [woman laughs], но они работают стабильнее всего, если пол спикера (Speaker History) совпадает с тегом.

3. Генерация пения и музыки

Чтобы заставить модель «пропеть» текст, а не прочитать его, используются музыкальные ноты.

  • Метод: Оберните текст в символы музыкальных нот ♪ (Shift + Alt + V на Mac или Alt+13 на Win, или просто скопируйте).

  • Пример: ♪ In the jungle, the mighty jungle, the lion sleeps tonight ♪

  • Совет: Это работает лучше всего, если вы используете английский язык, так как обучающий датасет содержал много английских песен, но на русском тоже можно добиться результата.

4. Паузы и интонация (Prosody)

Хотя специальных тегов для пауз (типа ) нет, Bark чувствителен к пунктуации и спецсимволам, так как воспринимает текст как структуру.

  • Двоеточие и тире (..., —): Используйте многоточие или длинное тире для создания пауз, колебаний или заминок в речи.

    • Пример: Я... я не уверен, что это правильно.

  • CAPS LOCK: Иногда (не гарантированно) написание слова ЗАГЛАВНЫМИ БУКВАМИ может добавить ударение или повысить громкость.

5. Важные нюансы работы (Disclaimer)

  1. Вероятностная природа: Bark — это GPT для аудио. Если вы напишете [laughter], модель с высокой вероятностью сгенерирует смех, но иногда она может проигнорировать тег или сгенерировать странный звук.

  2. Контекст имеет значение: Тег [laughter] сработает естественнее после шутки, чем посреди трагического предложения. Модель «понимает» семантику текста.

  3. Шепот (Whispering): Официального тега [whisper] нет. Однако сообщество заметило, что добавление слов типа "quietly" или использование специфических спикеров (Speaker Prompts) иногда помогает, но это метод проб и ошибок.

Ограничения на сайте: в данный момент все отправленные тексты обрезаются до 1000 символов.

🗎 Копировать ссылку Use algorithm Demo

MVSep MultiSpeaker (MDX23C)

MVSep MultiSpeaker (MDX23C) — данная модель пытается изолировать самый громкий голос от всех остальных голосов. Модель основана на архитектуре MDX23C. Все еще в разработке.

🗎 Копировать ссылку Use algorithm Demo
  • ‹
  • 1
  • 2
  • 3
  • ›
MVSEP Logo
Связаться со службой поддержки
Google Play App Store
Информация о сайте

Частые вопросы

Проверка качества алгоритмов

Алгоритмы

Полная документация по API

Как работает очередь

Компания

Политика конфиденциальности

Условия и положения

Политика возврата

Cookie Notice

Инцидент безопасности (октябрь 2026)

Дополнительно

Помогите в продвижении!