MVSEP Logo
  • Главная
  • Новости
  • Тарифы
  • Демо
  • Инструменты
  • Создать учетную запись
  • Войти
  • Тема
    Выбор модели
    Язык
    • English
    • Русский
    • 中文
    • اَلْعَرَبِيَّةُ
    • Polski
    • Portugues do Brasil
    • Español
    • 日本語
    • Français
    • Oʻzbekcha
    • Türkçe
    • हिन्दी
    • Tiếng Việt
    • Deutsch
    • 한국어
    • Bahasa Indonesia
    • Italiano
    • Svenska
    • suomi
    • български език
    • magyar nyelv
    • עִבְֿרִית
    • ภาษาไทย
    • hrvatski
    • Română
    • Українська
    Server DE2

Алгоритмы

Bark (Speech Gen)

Bark — это созданная компанией Suno модель на базе архитектуры трансформеров, которая представляет собой не просто традиционный инструмент синтеза речи, а полноценную генеративную систему класса «текст в аудио». Её возможности выходят далеко за рамки обычного озвучивания: помимо создания высокореалистичной речи на множестве языков, Bark умеет генерировать музыку, фоновые шумы и простые звуковые эффекты. Уникальной особенностью модели является способность воспроизводить тонкие невербальные коммуникации, такие как смех, вздохи и плач, что делает итоговое звучание максимально живым и естественным.

Стремясь поддержать сообщество, разработчики открыли доступ к предварительно обученным контрольным точкам, которые готовы к работе и разрешены даже для коммерческого использования. Тем не менее важно учитывать, что Bark создавался в первую очередь для исследовательских задач. Будучи полностью генеративной моделью, она может вести себя непредсказуемо и иногда отклоняться от введенных текстовых подсказок.

Официальный репоизторий модели: https://github.com/suno-ai/bark

В отличие от классических TTS-систем, Bark не использует SSML-разметку. Вместо этого он обучен распознавать определенные текстовые вставки (теги) как инструкции для генерации звуков.

Инструкция по кодированию эмоций и звуков в Bark

1. Основной принцип

Все управляющие команды пишутся в квадратных скобках. Важно: Сами теги должны быть написаны на английском языке, даже если основной текст, который вы генерируете, на русском, испанском или любом другом языке.

Синтаксис:

Текст до эффекта [тег_эффекта] текст после эффекта.

2. Список поддерживаемых тегов (Non-speech sounds)

Bark официально распознает следующий набор токенов для невербальных звуков:

Тег Описание Пример использования
[laughter] Громкий, явный смех Привет! [laughter] Как же это было смешно.
[laughs] Короткий смешок, хихиканье Ну да, конечно [laughs].
[sighs] Тяжелый вздох (усталость, облегчение) [sighs] Я так устал от этой работы.
[music] Вставка инструментальной музыки [music] (играет фоновая музыка)
[gasps] Резкий вдох (испуг, удивление) [gasps] Я не ожидал тебя здесь увидеть!
[clears throat] Откашливание (привлечение внимания) [clears throat] Господа, прошу внимания.

Примечание: Также существуют вариации [man laughs] и [woman laughs], но они работают стабильнее всего, если пол спикера (Speaker History) совпадает с тегом.

3. Генерация пения и музыки

Чтобы заставить модель «пропеть» текст, а не прочитать его, используются музыкальные ноты.

  • Метод: Оберните текст в символы музыкальных нот ♪ (Shift + Alt + V на Mac или Alt+13 на Win, или просто скопируйте).

  • Пример: ♪ In the jungle, the mighty jungle, the lion sleeps tonight ♪

  • Совет: Это работает лучше всего, если вы используете английский язык, так как обучающий датасет содержал много английских песен, но на русском тоже можно добиться результата.

4. Паузы и интонация (Prosody)

Хотя специальных тегов для пауз (типа ) нет, Bark чувствителен к пунктуации и спецсимволам, так как воспринимает текст как структуру.

  • Двоеточие и тире (..., —): Используйте многоточие или длинное тире для создания пауз, колебаний или заминок в речи.

    • Пример: Я... я не уверен, что это правильно.

  • CAPS LOCK: Иногда (не гарантированно) написание слова ЗАГЛАВНЫМИ БУКВАМИ может добавить ударение или повысить громкость.

5. Важные нюансы работы (Disclaimer)

  1. Вероятностная природа: Bark — это GPT для аудио. Если вы напишете [laughter], модель с высокой вероятностью сгенерирует смех, но иногда она может проигнорировать тег или сгенерировать странный звук.

  2. Контекст имеет значение: Тег [laughter] сработает естественнее после шутки, чем посреди трагического предложения. Модель «понимает» семантику текста.

  3. Шепот (Whispering): Официального тега [whisper] нет. Однако сообщество заметило, что добавление слов типа "quietly" или использование специфических спикеров (Speaker Prompts) иногда помогает, но это метод проб и ошибок.

Ограничения на сайте: в данный момент все отправленные тексты обрезаются до 1000 символов.

🗎 Копировать ссылку Use algorithm Demo

MVSep MultiSpeaker (MDX23C)

MVSep MultiSpeaker (MDX23C) — данная модель пытается изолировать самый громкий голос от всех остальных голосов. Модель основана на архитектуре MDX23C. Все еще в разработке.

🗎 Копировать ссылку Use algorithm Demo

UniverSR (Super Resolution)

UniverSR — алгоритм сверхразрешения звука (audio super resolution) для восстановления высоких частот. Он основан на статье UniverSR: Unified and Versatile Audio Super-Resolution via Vocoder-Free Flow Matching (ICASSP 2026). 

Поддерживает вход 8/12/16/24 кГц с выходом 48 кГц. Доступны две модели: universal (все типы аудио) и speech (речь).

Режим автоопределения входной полосы: если входной файл имеет частоту дискретизации 8/12/16/24 кГц, используется его родная частота; для файлов 44.1/48 кГц эффективная полоса считается равной 16 кГц (типично для старых записей и lossy-кодеков), восстанавливается всё выше 8 кГц; остальные частоты дискретизации (11.025/22.05/32 кГц) округляются вниз до ближайшей поддерживаемой. Полосу можно также задать вручную (8000/12000/16000/24000) — она не должна быть выше реальной полосы записи, иначе настоящие высокие частоты будут заменены сгенерированными.

Guidance scale управляет плотностью генерируемых высоких частот: более высокие значения дают более яркое, но менее точное восстановление (при значениях 3.0+ появляются шипение и клиппинг). Рекомендуемые значения: 1.0-1.5 для речи, 1.5-2.0 для музыки. По умолчанию: 1.5.

Оригинальный репозиторий: https://github.com/woongzip1/UniverSR
Предобученные веса: woongzip1/universr-audio, woongzip1/universr-speech

🗎 Копировать ссылку Use algorithm Demo

Clean Inverted Vocals

Обе эти модели специально созданы для очистки вокала (акапеллы) от артефактов после фазовой инверсии - процесса, когда из оригинального трека вычитается официальный инструментал. Стандартные модели для извлечения вокала обычно не справляются со специфическими искажениями, остающимися после такой процедуры (особенно если исходники были сжаты, например, в MP3).

  • bsroformer_cleaninvert (от gilliaan): Более новая модель (дообученная версия "Revive"). Заточена под удаление "пиксельных" и размазанных артефактов MP3-сжатия, а также треска и клиппинга. Делает инвертированную акапеллу максимально похожей на чистый студийный исходник. Автор рекомендует сначала обрабатывать вокал моделью "big beta 5e", а затем вычищать остатки этой моделью.
    Оригинальные веса

  • Mel-Roformer invert-clean (от becruily): Более ранняя модель для аналогичной задачи. Отлично справляется с щелчками, резкими пиками и "упрямыми" остатками инструментала. Меньше фокусируется на полноте звучания вокала и может слегка мутить звук на очень громких участках, но эффективно вычищает мусор.
    Оригинальные веса

Хотя обе модели технически могут извлекать вокал и из обычных (не инвертированных) песен, для этих целей лучше подходят стандартные модели. Главная специализация этих двух нейросетей - именно "генеральная уборка" сложных артефактов, оставшихся после вычитания инструментала.

🗎 Копировать ссылку Use algorithm Demo

Aspiration (by Sucial)

Алгоритм добавляет к вокалу эффект «шепота». Модель создана SUC-DriverOld. Подробнее здесь.

Модель Aspiration отделяет:

  1. Слышимое дыхание

  2. Шипение и жужжание фрикативных согласных (например, «с» и «ф»)

  3. Взрывные согласные: глухой взрывной звук, возникающий при произнесении согласных (таких как "п", "т", "к").

🗎 Копировать ссылку Use algorithm Demo

Phantom Centre extraction

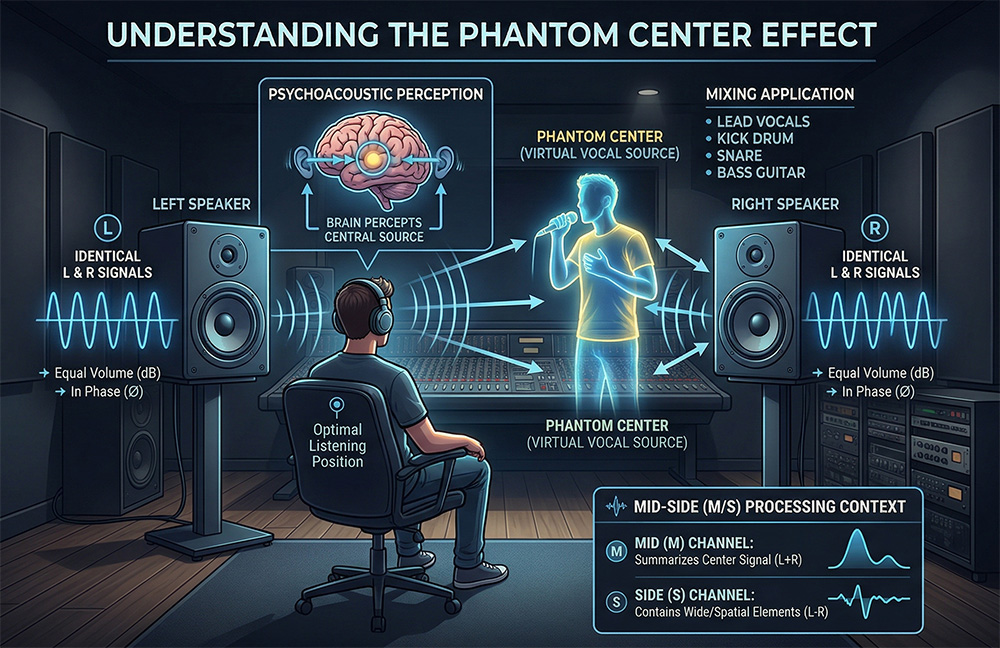
Что такое фантомный центр (Phantom Center) в звукорежиссуре?

Слушая музыку в стерео, мы часто отчетливо слышим вокал, звучащий прямо перед нами. Но если вы посмотрите на свою акустическую систему, то увидите лишь две колонки по бокам. Источника звука посередине нет. То, что вы слышите — это фантомный центр.

Как это работает? Фантомный центр — это психоакустическая иллюзия. Она возникает, когда левый и правый каналы воспроизводят один и тот же моно-сигнал с абсолютно одинаковой громкостью и в одинаковой фазе. Наш мозг обрабатывает звук, приходящий в оба уха одновременно, и "дорисовывает" виртуальный источник звука прямо по центру.

Почему фантомный центр так важен при сведении?

  • Фундамент микса: Традиционно в центр помещают самые важные и "энергоемкие" элементы трека. Главный вокал, бас-гитара, бочка (kick) и малый барабан (snare) панорамируются строго в ноль (по центру). Это гарантирует, что энергия низких частот равномерно распределяется на оба монитора, делая микс пробивным и плотным.

  • Контраст и ширина: Фантомный центр служит точкой отсчета для всего остального микса. Широкие стереоэффекты, дабл-треки гитар или объемные синтезаторы звучат широко именно благодаря контрасту с плотным и узким фантомным центром.

  • Mid/Side обработка: В современных технологиях мастеринга и извлечения стемов (source separation) фантомный центр часто выделяют в отдельный канал — Mid (середина), который вычисляется как сумма левого и правого каналов. Это позволяет эквализировать или изолировать вокал и ритм-секцию, не затрагивая инструменты, звучащие по краям (Side).

Опасности фантомного центра Эта иллюзия очень хрупкая. Если сигнал в одном из каналов задержится хотя бы на миллисекунду или его фаза будет нарушена, центр "поплывет" или вовсе исчезнет из-за фазового вычитания. Поэтому при работе со стереорасширителями всегда важно проверять трек на моносовместимость.

У нас на данный момент доступно два алгоритма извлечения фантомного центра. Ниже приведены их метрики качества полученные на валидационном датасете:

Model Center SDR Center L1Freq Center fullness Center bleedless 
Phantom Centre by wesleyr36 (mdx23c) 8.25 27.52 19.44 38.92
Phantom Centre by gilliaan (BSRoformer) 16.45 44.00 37.17 48.76
Phantom Centre by gilliaan (mdx23c) 18.93 49.20 45.85 45.54

🗎 Копировать ссылку Use algorithm Demo

Matchering (by sergree)

Matchering — это новый инструмент для сопоставления и мастеринга аудио. Он основан на простой идее: вы берете ДВА аудиофайла и загружаете их в Matchering:

  • TARGET (трек, который вы хотите смастерить и вы хотите, чтобы он звучал как референс)
  • REFERENCE (другой трек, например, какая-нибудь «фирменная» популярная песня, вы хотите, чтобы ваш целевой трек звучал так же)

Алгоритм сопоставляет оба этих трека и предоставляет вам обработанный трек TARGET с теми же значениями RMS, частотной характеристики, пиковой амплитуды и ширины стереобазы, что и у трека REFERENCE.

Основано на коде @sergree.

🗎 Копировать ссылку Use algorithm Demo

SOME (Singing-Oriented MIDI Extractor)

SOME (Singing-Oriented MIDI Extractor) — это инструмент для извлечения MIDI, способный конвертировать пение в MIDI-последовательность. Модель была обучена исключительно на китайском вокале, поэтому с другими языками она может работать некорректно.

Оригинальная страница: https://github.com/openvpi/SOME

🗎 Копировать ссылку Use algorithm Demo

Transkun (Piano → MIDI)

Transkun — это современная open-source модель для автоматической транскрипции фортепианной музыки (Audio-to-MIDI). Официальная страничка модели: здесь. Она считается одной из лучших (SOTA — State of the Art) в своем классе. Модель умеет распознавать не только сами ноты, но и их длительность, громкость (velocity) и использование педали. В отличие от многих старых моделей, которые анализируют музыку «покадрово» (frame-based), Transkun использует подход Neural Semi-CRF (semi-Markov Conditional Random Field). Вместо того чтобы спрашивать «звучит ли нота в эту миллисекунду?», модель рассматривает события как цельные интервалы (от начала до конца ноты). В последних версиях используется Transformer (Non-Hierarchical Transformer), который вычисляет вероятность того, что определенный отрезок времени является нотой. Декодинг: Используется алгоритм Витерби (Viterbi) для поиска наиболее вероятной последовательности непересекающихся интервалов. Модель показывает отличные результаты на датасете MAESTRO (стандарт индустрии).

🗎 Копировать ссылку Use algorithm Demo

Basic Pitch (MIDI Extraction)

Basic Pitch — это современная нейросеть от исследовательской лаборатории Spotify (Audio Intelligence Lab), которая переводит любые мелодические аудиозаписи в ноты (формат MIDI). В отличие от устаревших конвертеров, эта модель умеет «слышать» не только отдельные ноты, но и аккорды, а также тончайшие нюансы исполнения. Официальная страница модели: https://github.com/spotify/basic-pitch

Ключевые возможности

  • Полифоническое распознавание: Basic Pitch не боится сложностей. Вы можете загружать записи фортепиано, гитары или ансамбля — модель распознает несколько нот, звучащих одновременно.
  • Сохранение нюансов (Pitch Bend): Большинство конвертеров «квантуют» звук до ближайшей ноты, делая его плоским. Basic Pitch сохраняет изменения высоты тона (pitch bends). Если вы поете с вибрато или делаете подтяжки на гитаре, эти детали останутся в MIDI-файле.
  • Универсальность: Модель обучена на огромном массиве данных и работает с большинством мелодических инструментов.
  • Скорость и легкость: Это «легковесная» модель, которая обрабатывает аудио быстро, не требуя мощных серверов.

С чем работает модель?

Basic Pitch — это «инструментально-агностическая» модель. Это значит, что она одинаково хорошо справляется с разными тембрами:
- Вокал: Напойте мелодию в микрофон, и нейросеть превратит ваш голос в партию для синтезатора.
- Струнные: Акустическая и электрогитара, скрипка, виолончель.
- Клавишные: Фортепиано, рояль, органы и синтезаторы.
- Духовые: Флейта, саксофон, труба и другие.

Важно: Модель предназначена для мелодических инструментов. Она не подходит для распознавания ударных (барабанов и перкуссии), так как фокусируется на высоте тона, а не на ритмическом шуме.

🗎 Копировать ссылку Use algorithm Demo

ADTOF Plus (Drums → MIDI)

Это модель для транскрипции барабанов в MIDI-файлы. Для облегчения работы встроена возможность предварительного извлечения барабанов из полноценного микса. Для этого используются лучшая модель MVSep для выделения барабанов и модель MelBand Roformer для разделения ударных (DrumSep) на 6 частей. Далее используется модель ADTOF для получения MIDI-файла.

Статья о модели ADTOF: https://doi.org/10.3390/signals4040042
Оригинальная модель: https://github.com/MZehren/ADTOF
Модель на базе PyTorch: https://github.com/xavriley/ADTOF-pytorch
Пайплайн на базе моделей MDX23C: https://github.com/xavriley/adtof_plus_drum_transcription

🗎 Копировать ссылку Use algorithm Demo

Muscriptor

MuScriptor - модель с открытыми весами для автоматической транскрипции музыки с несколькими инструментами, разработанная Kyutai и Mirelo AI. Она преобразует музыкальную запись в MIDI-файл: для каждой ноты определяются высота, время начала и окончания, а также инструмент, на котором она сыграна. На MVSep используется самая большая и точная версия модели (MuScriptor large, ~1.3 млрд параметров, Transformer-декодер).

Модель распознаёт 34 группы мелодических инструментов и ударные. Лучше всего транскрибируются фортепиано, гитары, бас и ударные, так как они чаще всего встречаются в обучающих данных. Темп и размер трека определяются автоматически и записываются в MIDI-файл.

Настройки

  • Квантизация нот - выравнивание нот по найденной сетке долей. Полезно для нотных редакторов и DAW. Лучше всего работает на записях с постоянным темпом; для записей с рубато или живых выступлений без фиксированного темпа эту настройку лучше не включать.
  • Инструменты - позволяет ограничить транскрипцию выбранными инструментами (например, только фортепиано, бас и ударные). Ноты других инструментов в результат не попадут. Оставьте поле пустым, чтобы модель сама определила все инструменты.

Поддерживаемые инструменты

акустическое фортепиано, электропиано, хроматические ударные (челеста, глокеншпиль, вибрафон, маримба, ксилофон, колокола), орган (включая аккордеон и губную гармонику), акустическая гитара, чистая электрогитара, электрогитара с перегрузом, акустический бас, электробас, скрипка, альт, виолончель, контрабас, арфа, литавры, струнный ансамбль, синтезаторные струнные, голос / хор, оркестровый удар, труба, тромбон, туба, валторна, медная духовая секция, сопрано- и альт-саксофон, тенор-саксофон, баритон-саксофон, гобой, английский рожок, фагот, кларнет, флейты (включая пикколо, блокфлейту, пан-флейту), синтезаторный лид, синтезаторный пэд, ударные.

Ограничения

  • Громкость нот (velocity) не определяется — у всех нот одинаковая громкость.
  • Для ударных определяются только моменты ударов (без длительности).
  • Внутри группы конкретный инструмент не различается (например, любой электробас записывается одной и той же басовой программой).

Качество

F1-метрики (%), опубликованные авторами для их отложенного тестового набора из 372 треков (без учёта инструмента, вычислены с помощью mir_eval):

Модель Onset F1 Frame F1 Offset F1 Drums F1 Multi-instrument F1
YourMT3+ (базовая модель) 32.5 45.5 17.8 41.4 21.9
MuScriptor large 60.4 72.4 48.6 49.6 47.8

Ссылки

  • Оригинальная страница: github.com/muscriptor/muscriptor
  • Веса модели: huggingface.co/MuScriptor/muscriptor-large
  • Статья: MuScriptor: An Open Model for Multi-Instrument Music Transcription (ISMIR 2026)
  • Онлайн-демо от авторов: muscriptor.kyutai.org

© Kyutai, Mirelo AI. Авторы: Rouard, Krause, Roebel, Simon-Gabriel, Défossez

🗎 Копировать ссылку Use algorithm Demo

HeartMuLa (Song Gen)

HeartMuLa — это передовое семейство мультимодальных базовых моделей (Foundation Models) с открытым исходным кодом (лицензия Apache 2.0), предназначенное для высококачественного синтеза музыки и работы со звуком. В отличие от проприетарных облачных сервисов (таких как Suno или Udio), HeartMuLa предоставляет разработчикам полный контроль над процессом генерации и возможность локального запуска на собственном оборудовании. Модель работает на базе LLM-архитектуры и позволяет создавать полноценные композиции по текстовым промптам.

Официальный репозиторий: https://github.com/HeartMuLa/heartlib

Ключевые возможности

  • Мультиязычная генерация вокала: Поддерживается синтез речи и пения на нескольких языках, включая английский, китайский, японский, корейский и испанский.

  • Тонкий структурный контроль: Использование специальных тегов в текстах (например, [Intro], [Verse], [Chorus], [Bridge]) позволяет точно управлять аранжировкой и развитием композиции.

  • Управление музыкальными атрибутами: Модель отлично понимает комплексные описания. Вы можете задавать жанр (рок, джаз, R&B, метал), тембр (dark, bright, soft), эмоции и конкретные инструменты.

В текущей базовой версии HeartMuLa полноценная поддержка русского языка не заявлена.

  • Для вокала (тексты песен): Модель официально оптимизирована для работы только с пятью языками: английским, китайским, японским, корейским и испанским. Если передать ей текст на кириллице, результат «из коробки», скорее всего, будет нестабильным — от сильного акцента и искажения слов до полной фонетической бессмыслицы.

  • Для промптов (описание музыки): Задавать жанр, настроение, структуру и инструменты (теги) также нужно строго на английском языке. Встроенный модуль выравнивания (HeartCLAP) обучался на англоязычных датасетах, поэтому русские описания он просто не поймет.

Архитектура: как это работает под капотом

Система не является монолитной; это комплекс из нескольких специализированных нейросетей, объединенных в единый пайплайн обработки аудио:

  1. HeartCodec (Нейрокодек): Основа системы — токенизатор музыки, работающий на экстремально низкой частоте (12.5 Гц). Он обеспечивает высочайшую точность реконструкции сигнала (high fidelity) при минимальном объеме данных. Это критически важно для того, чтобы языковая модель могла эффективно генерировать длинные аудиофрагменты в авторегрессионном режиме.

  2. HeartCLAP: Модель выравнивания текста и звука (audio-text alignment). Она создает единое пространство эмбеддингов, благодаря которому текстовое описание "грустная мелодия на акустической гитаре" математически точно сопоставляется с нужными акустическими характеристиками.

  3. HeartTranscriptor: Модуль на базе архитектуры Whisper, дообученный специально для транскрибации текстов песен и извлечения фонетических признаков из вокала.

  4. Генератор HeartMuLa: Основная LLM-модель с трехуровневой архитектурой:

    • Глобальный backbone обрабатывает текстовые токены и аудиокодировки.

    • Локальный декодер отвечает за непосредственный синтез музыки на основе скрытых состояний.

    • Детокенизатор переводит сгенерированные токены обратно в непрерывную звуковую волну (waveform).

Для обучения использовалась стратегия мульти-энкодера: модель извлекает данные из предобученных сетей Whisper, WavLM и собственного MuEncoder, что позволяет анализировать звук одновременно на фонетическом, семантическом и акустическом уровнях.

Важное примечание: В целях соблюдения этики ИИ, согласно технической документации разработчиков, в сгенерированные треки встраивается невидимый цифровой водяной знак (watermark) для идентификации машинного происхождения аудио.

Руководство: Как правильно оформлять тексты и использовать теги

При работе с ИИ-моделями для генерации музыки текст (лирика) выполняет две функции: он говорит модели, что петь, а мета-теги в квадратных скобках [...] указывают, как это петь и как выстраивать структуру трека. Модель воспринимает теги как режиссерские указания.

1. Базовые структурные теги (Каркас песни)

Эти теги разбивают сплошной текст на логические музыкальные блоки. Их нужно писать с новой строки перед блоком текста.

  • [Intro] — Вступление. Задает настроение и темп до начала вокала. Под этим тегом обычно не пишут текст, либо добавляют короткие атмосферные фразы или вокализы (например, Ooh-ooh).

  • [Verse] (или [Verse 1], [Verse 2]) — Куплет. Здесь раскрывается история. Музыка в куплетах обычно более спокойная, а ритм — ровный. Использование нумерации помогает модели понять, что мелодия должна повторяться, но текст будет новым.

  • [Pre-Chorus] — Предприпев. Переходная часть, где нарастает напряжение и плотность инструментов перед главной кульминацией.

  • [Chorus] — Припев. Главная мысль и самая запоминающаяся мелодия. Здесь модель обычно выдает максимум эмоций, плотности звука и вокальной экспрессии.

  • [Bridge] — Бридж (мост). Вставляется ближе к концу песни (обычно после второго припева). В этой части кардинально меняется мелодия, ритм или тональность, чтобы песня не казалась монотонной.

  • [Outro] — Кода (завершение). Плавное затухание музыки (fade-out) или красивый финальный аккорд.

2. Инструментальные и стилистические теги

Вы можете управлять не только структурой, но и аранжировкой в конкретные моменты времени.

  • Соло и проигрыши: Используйте теги вроде [Guitar Solo], [Piano Interlude], [Bass Drop] или [Drum Fill] между куплетами и припевами. Текст под ними писать не нужно.

  • Вокальные указания: Если модель это поддерживает, можно задавать стиль исполнения перед строкой: [Whisper], [Scream], [Spoken], [Choir].

  • Бэк-вокал и эхо: Чтобы добавить бэк-вокал или хоровые ответы, заключайте слова в круглые скобки. Например: Lead: Walking down this lonely road Backing: (lonely road)

3. Золотые правила написания самого текста

Даже с идеальными тегами ИИ может запутаться, если сам текст плохо структурирован.

  1. Симметрия и ритмика: ИИ-модели опираются на количество слогов. Постарайтесь, чтобы строки в одном куплете имели примерно одинаковое количество слогов и четкий размер. Если одна строка состоит из 5 слов, а следующая из 15 — модель начнет "жевать" слова или сломает ритм.

  2. Пунктуация — это дыхание: Запятые , и точки . работают как паузы. Если вам нужно, чтобы вокалист взял дыхание или сделал паузу перед важным словом, поставьте запятую. Отсутствие знаков препинания заставит ИИ петь скороговоркой.

  3. Язык: Как мы обсуждали ранее, пишите тексты строго на английском языке (или другом официально поддерживаемом), чтобы избежать фонетического "мусора" и акцента.

  4. Разделение: Обязательно оставляйте пустую строку (перенос) между разными блоками (между куплетом и припевом).

4. Идеальный шаблон (Пример)

Вот как должен выглядеть грамотно составленный промпт для генерации:

[Intro]
[Verse]
You could, you could take me to a place that's new,
A wave or a cloud, holding hands with only you.
You could, you could tell me that you have it all,
Everything I wanted, catching me before I fall.

[Chorus]
Take me out for a ride,
Along the docks or in the wood,
You could make me sick inside,
In just a single word you could.

[Chorus]
The sky would think it's right,
It loves the simple things,
My heart against yours tight,
If you love the simple things.
No, let's not do what others do
La, lalala, lalala
If you love the simple things
La, lalala, lalala, lalala la la la

[Verse]
You could, you could take me out to eat somewhere,
The finest of tables, honestly I do not care.
You could, you could use your charms to make me yield,
Step right up to me and make me drop my shield.

[Chorus]
Take me out for a ride,
Along the docks or in the wood,
You could make me sick inside,
In just a single word you could.

[Chorus]
The sky would think it's right,
It loves the simple things,
My heart against yours tight,
If you love the simple things.
No, let's not do what others do

[Bridge]
Take me my boy, let me take a little bite,
Behind a deep feeling hides a man of great might.
Make me fly my boy, tell me if we are alright,
Behind a deep feeling hides a man of great might.

[Chorus]
Take me out for a ride,
Along the docks or in the wood,
You could make me sick inside,
In just a single word you could.

[Chorus] 
The sky would think it's right,
It loves the simple things,
My heart against yours tight,
If you love the simple things.
La, lalala, lalala
If you love the simple things
La, lalala, lalala
La la la la la la la

Руководство по тегам (Промпт-инжиниринг)

Это руководство основано на анализе научной статьи по HeartMuLa (разделы 3.2 и 6.2). Модель использует токенизатор естественного языка (Llama 3), а не фиксированный словарь. Для достижения стабильной генерации выбирайте теги из 8 основных категорий, которые использовались при обучении.

8 столпов обучения

Каждая категория имеет процент важности, отражающий «вероятность выбора» во время обучения.

  • Частота при обучении: Теги «семплировались» (выбирались) в процессе обучения. Жанр включался в 95% случаев, тогда как Инструмент — только в 25%.

  • Ожидания модели: Для корректной работы модель ожидает наличие тега жанра. Без него генерации не хватает четкого структурного якоря.

  • Влияние и стабильность: Более высокий процент означает большую стабильность. Тег с вероятностью 95% (Жанр) — это «сильный якорь», тогда как тег с 10% (Тема) — это «слабая подсказка», которая может быть проигнорирована, если она конфликтует с более сильными тегами.

  • Стратегия: Для максимального контроля активно опирайтесь на 4 топовые категории (Жанр, Тембр, Пол, Настроение). Используйте теги с низким процентом только как «приправу» после того, как задана основная структура.

Официальные категории

GENRE / ЖАНР (95% — ОБЯЗАТЕЛЬНО)

  • Примеры: Pop, Rock, Electronic, Hiphop, Jazz, Classical, Techno, Trance, Ambient.

TIMBRE / ТЕМБР (50% — Текстура звука)

  • Примеры: Soft, Warm, Husky, Bright, Dark, Distorted.

GENDER / ПОЛ ВОКАЛИСТА (37% — Характер вокала)

  • Примеры: Male, Female.

MOOD / НАСТРОЕНИЕ (32% — Эмоциональный вайб)

  • Примеры: Happy, Sad, Energetic, Joyful, Melancholic, Relaxing, Dark.

INSTRUMENT / ИНСТРУМЕНТ (25% — Доминирующие звуки)

  • Примеры: Piano, Synthesizer, Acoustic Guitar, Electric Guitar, Bass, Drums, Strings, Violin.

SCENE / СЦЕНА (20% — Контекст прослушивания)

  • Примеры: Dance, Workout, Dating, Study, Cinematic, Party.

REGION / РЕГИОН (12% — Культурное влияние)

  • Примеры: K-pop, Latin, Western.

TOPIC / ТЕМА (10% — Лирическая тема)

  • Примеры: Love, Summer, Heartbreak.

Для удобства все 8 категорий и возможные теги для них вынесены в отдельные опции выбора на сайте. Вы можете не указывать их и ввести свой набор тегов в строке Tags (otional).

Стратегия промптинга: «Меньше — значит больше»

Чтобы сохранить сильный якорь и избежать «интерференции вероятностей», не используйте конфликтующие теги.

  • Семантический конфликт: Запрос «Rock, Jazz» рассеивает внимание модели, что часто приводит к «грязи» или невыразительным, шаблонным аранжировкам.

  • Стабильность якоря: Один сильный якорь дает четкую карту действий. Несколько жанров создают конфликтующие карты, из-за чего ИИ теряет фокус.

  • Рекомендация: Выбирайте только один тег для каждой категории. Будьте точны, избегайте слишком широких понятий.

Рекомендуемый формат

Используйте список, разделенный запятыми.

Примеры:

  • Electronic, Techno, Synthesizer, Dark, High Energy, Club

  • Pop, Piano, Female, Sad, Soft, Love, Acoustic
🗎 Копировать ссылку Use algorithm Demo

Vit Large 23 (vocals, instrum)

Экспериментальная модель VitLarge23 на базе Vision Transformers. По метрикам немного уступает MDX23C, но может сработать лучше в некоторых случаях.

Таблица качества

Algorithm name Multisong dataset Synth dataset MDX23 Leaderboard
SDR Vocals SDR Instrumental SDR Vocals SDR Instrumental SDR Vocals
Vit Large 23 (512px) v1 9.78 16.09 12.33 12.03 10.47 
Vit Large 23 (512px) v2 9.90 16.20 12.38 12.08 ---
🗎 Копировать ссылку Use algorithm Demo

MVSep MelBand Roformer (vocals, instrum)

Mel Band Roformer - модель предложенная сотрудниками компании ByteDance для конкурса Sound Demixing Challenge 2023, где они заняли первое место на LeaderBoard C. К сожалению, модель не была выложена в открытый доступ и была воспроизведена по научной статье разработчиком @lucidrains на площадке github. Вокальная модель была обучена с нуля на нашем внутреннем датасете. К сожалению, нам пока не удалось достичь аналогичных метрик как у авторов.

Таблица качества

Algorithm name Multisong dataset Synth dataset MDX23 Leaderboard
SDR Vocals SDR Instrumental SDR Vocals SDR Instrumental SDR Vocals
Mel Band Roformer v1 (vocals) 9.07 --- 11.76 --- ---
🗎 Копировать ссылку Use algorithm Demo

LarsNet (kick, snare, cymbals, toms, hihat)

Модель LarsNet производит разделение дорожки барабанов на 5 типов: 'kick', 'snare', 'cymbals', 'toms', 'hihat'. Используется модель из репозитория на github и обученная на датасете StemGMD. Модель имеет два режима работы. В первом (по умолчанию) сначала к треку применяется модель Demucs4 HT, которая извлекает из трека только барабанную часть. Далее уже применяется модель LarsNet. Если ваш трек состоит только из барабанов, то имеет смысл использовать второй режим, где модель LarsNet применяется непосредственно к загруженному аудио. К сожалению, субъективно качество разделения уступает по качеству модели DrumSep.

🗎 Копировать ссылку Use algorithm Demo
  • ‹
  • 1
  • 2
  • 3
  • ›
MVSEP Logo
Связаться со службой поддержки
Google Play App Store
Информация о сайте

Частые вопросы

Проверка качества алгоритмов

Алгоритмы

Полная документация по API

Как работает очередь

Компания

Политика конфиденциальности

Условия и положения

Политика возврата

Cookie Notice

Инцидент безопасности (октябрь 2026)

Дополнительно

Помогите в продвижении!